



 智算多多
联系我们

官方邮箱:service@zsdodo.com

公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
关注我们

公众号

视频号
◎2025 北京智算多多科技有限公司版权所有 京ICP备 2025150592号-1  京公网安备11010602202532号
 为什么代码写得快,CI会直接暴毙?
最根本的原因在于,AI写代码的「行为模式」,与人类有着本质区别。
在传统软件研发流程中,人类工程师需要构思、敲键盘、本地调试,一天能提交的PR数量有限,且往往倾向于把一堆相关改动打包成一个中大型PR。
再加上,是人每天总归要休息的,CI集群因此有充分的低谷期来消化任务。
但换成Claude当主力程序员后,整个研发节奏彻底变天——
Claude极其偏爱提交粒度极细、体量更小的PR。
一个小修改就是一个PR,导致全系统在单位时间内需要触发的流水线频次呈几何级增长。
最要命的是,Agent根本不需要睡觉。
除了白天配合人类的高并发突发提交,Claude还在深夜和周末不间断地跑任务、提代码、做重构。
原本的系统「低谷期」被彻底抹平。
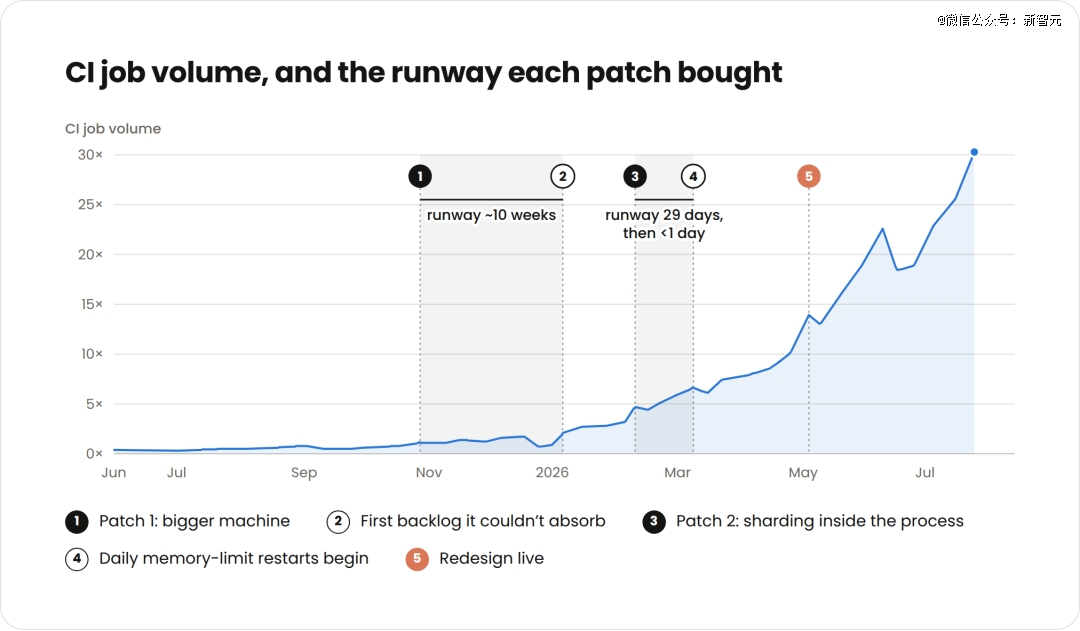
Claude写完逻辑后,会顺手写出密密麻麻的单元测试和集成测试,整个代码库的测试规模激增10倍。
如果换作传统做法,让每个PR都跑全量测试,CI流水线早就彻底超时卡死。
为此,Anthropic打造了一套确定性测试影响分析服务,核心依赖两个组件:
然而,这套在「人类时代」运作良好的架构,埋下了一个致命隐患:单点写入(Singleton)。
为了保证所有测试历史严格按时序记录,系统最初设计为单进程写入模式。
但面对Claude每秒持续倾泻而来的数千上万个并发任务,Listener开始严重滞后。
在AI原生开发生命周期中,哪怕Listener仅仅落后20分钟,就会导致数万次测试状态无法同步给Selector。
结果,错误代码被合并,其他工程师开始排查与自己无关的报错;偶发失败的测试开始阻塞合流;新增或修复的测试无法及时生效,回归风险飙升。
接下来,就是三次经典的「快速止血」。
Patch 1:换更大的机器。把核数翻倍。谁都知道这是临时的,但没人想到它只撑了70天。

Patch 2:分片。不再需要全局单一写入者,改为每个package一个独立的shard worker。这个方案撑了29天。
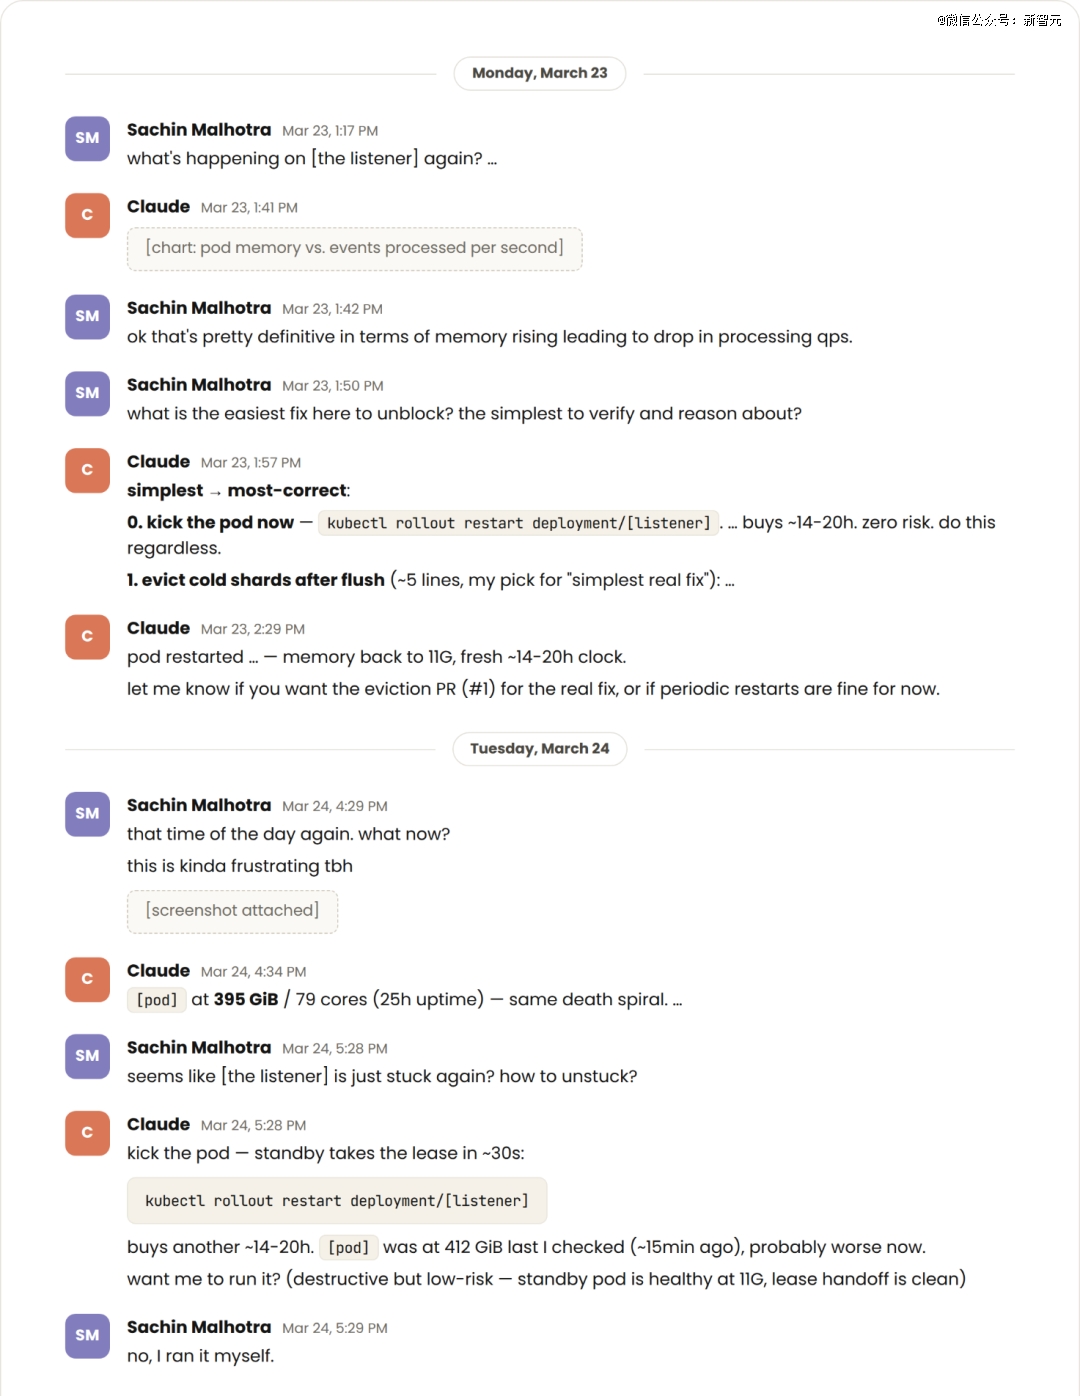
Patch 3:每日重启。
到了2026年3月,这台不断打补丁的单体服务彻底崩溃。
每个工作日刚过午后,进程就会直接触发内存上限(OOM)。团队排查了半天只找到4个微小Bug,尝试替换Go/Rust内存分配器以优化垃圾回收(GC),全部无济于事。
由于单点服务承受着超高负载,团队根本不敢冒着全线停摆的风险给它做生产环境内存分析(Profiling)。
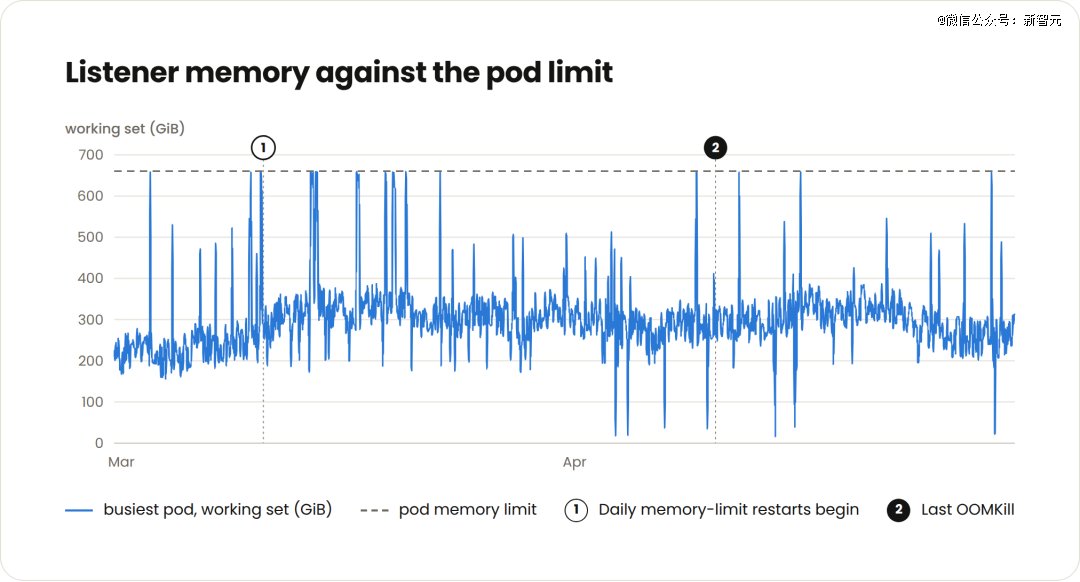
无奈之下,工程师启用了绝招,每日定时自动重启。
然而,在AI每秒几十倍的并发倾泻下,这套古老的"重启大法"连一天都撑不过去。
每日重启造成了严重的任务数据丢包,Listener经常连续落后1小时以上,测试选择器只能拿着陈旧数据瞎猜,导致全公司CI全线亮起大红灯,大面积瘫痪。
被逼到绝境的工程师,终于听从了Claude几个月前的建议:把整个服务炸掉,彻底推倒重来。
新架构的核心刀法极为干脆,彻底剥离单体内存状态,转向分布式无状态设计。
引入内存数据存储——异步轻量汇聚——Selector秒级只读解耦。
效果也是立竿见影,在上线切换并完成调优后,此前每周都在疯狂攀升、动辄堆积数十万的未处理事件队列,瞬间被拉成了一条贴地的水平直线!

Anthropic这次事故的意义,在于它验证了一个更根本的判断:
AI编程真正带来的冲击,已经从「程序员会不会失业」,进入「整套软件工程体系会不会过载」。
一个过去不起眼的单实例服务,完全可能成为整个团队等待的地方。
AI编程的竞争,正在从代码生成能力,延伸到整套工程体系的承载能力。
谁能让测试及时反馈、让结果可靠流转,谁才更有机会把新增代码变成真正可交付的软件。
代码可以一夜暴增,交付能力得跟上。
 智算多多
官方邮箱:service@zsdodo.com
公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
京公网安备11010602202532号