



 智算多多
联系我们

官方邮箱:service@zsdodo.com

公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
关注我们

公众号

视频号
◎2025 北京智算多多科技有限公司版权所有 京ICP备 2025150592号-1  京公网安备11010602202532号
 AI技术进步不及预期;下游需求不及预期;厂商竞争加剧。
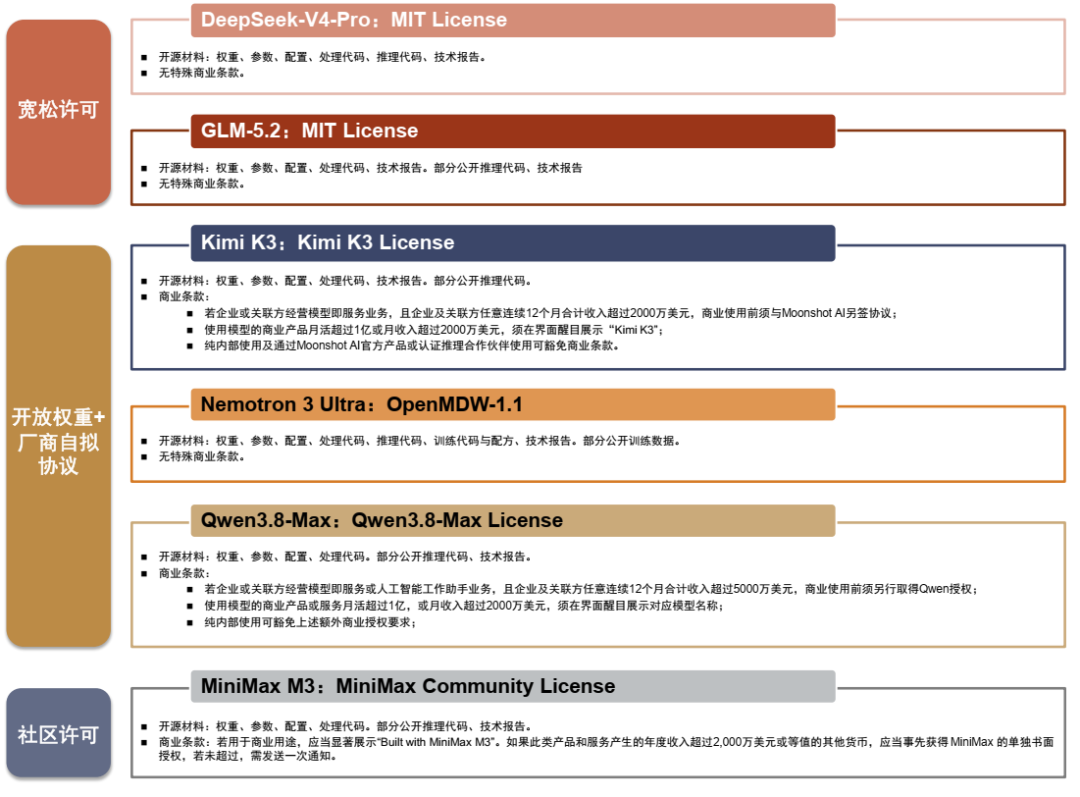
开源模型厂商相关开源协议和许可证具备差异。开源模型在开放模型权重和源代码时,也会发布相关开源协议让用户/第三方机构在有附件条件的情况下合理使用开源模型,开源附加条件主要包括三类:1)署名类,必须保留原作者的版权声明;2)互惠类,要求用户的衍生作品也必须以同样协议开源;3)限制类,限定用途、地区、规模,或超过某项标准另行谈判(各家模型自拟协议)。基于不同的附加条件,全球开源模型根据其许可证类型也可以分为三类:1)宽松许可类型(MIT/Apache 2.0),以GLM 5.2、DeepSeek V4 Pro为代表的模型采用MIT协议,特征为用户可以使用模型进行商业化、闭源二次分发、没有额外的附加条件限制;2)开放权重+厂商自拟协议,这种模式逐渐成为开源模型协议新趋势,例如,Kimi K3协议允许用户商用、微调、再分发模型,但有额外要求:保留版权声明;经营MaaS及关联方收入超过2000万美元须另签协议;月活超1亿或月收入超2000万美元须在界面标注Kimi K3;3)社区许可类型,以MiniMax为代表的MiniMax Community License,开放权重不等于自动任意商用,商业使用前需要授权/备案。因此,模型厂商开源协议不同,第三方平台依托开源模型实现商业化的条件有所差异。
开源模型衍生出多种商业模式,整体市场空间广阔。回顾软件开源的商业模式,主要包括四种方式:1)直接订阅模式,用户直接订阅软件服务,例如,MongoDB Atlas虽然开源,但是其对于分布式数据库的理解更为深刻,用户追求性能体验可以直接订阅MongoDB服务;2)服务模式,一方面是软件公司派驻场人员帮助客户部署开源软件和定制服务,而另一种订阅模式则是以Red Hat为代表,客户自行部署开源软件,软件厂商提供SLA支持、认证生态等支撑软件稳定运营的服务;3)Open Core模式,软件的核心部分免费,但部署给企业的功能收费,主要以GitLab、Elastic为代表;4)云托管模式,也就是云厂商部署开源软件,客户按照使用量付费给云厂商,主要以MongoDB Atlas、Confluent Cloud为代表,例如,客户通过AWS的Marketplace购买MongoDB Atlas,使用的是AWS的云资源和MongoDB的开源产品,但AWS需要给MongoDB分成。结合开源软件的商业模式,我们梳理出开源模型厂商及其生态的商业模式:

开源是有效的市场竞争策略,可以降低获客成本与促进生态建设。对于模型厂商来说,开源的价值不仅体现在向开发者开放模型权重、代码或工具链,更重要的是通过开放降低用户试用和迁移门槛,快速扩大开发者与企业用户覆盖面,构建围绕模型和基础设施的生态体系,从而形成网络效应与长期竞争壁垒。开源模型可以基于GitHub、Hugging Face等社区开发者的自传播快速获得大量自然流量,降低获客成本。同时,开源模型整个产业链的参与者众多、生态更为丰富,围绕开源模型形成的微调模型、推理框架、工具链、Agent等等数量提升,反哺开源模型的使用价值,并且由开发者/企业共同构建的生态圈,随着规模的不断扩大,模型的迁移成本和网络效应增强。而当模型能力趋于同质化时,开源模型所构筑的生态护城河反而助力其提升客户粘性与生产价值。
AI+安全时代,开源模型是维护基础设施安全运营的有效盾牌。大模型与Vibe Coding的渗透使得网络攻击变得简单,同时对于安全防护要求则是大幅提升,大模型的开放与生态协作将成为提升整体网络安全水平的重要途经。安全本身具备“攻防非对称”特征,也就是攻击者本身仅需要发现一个网络漏洞就可能造成大范围安全事件,而防护本身则是要求IT资产的每一部分都具备较强保护能力。开源模型可以助力防御方发现隐藏的安全漏洞,并且可以与安全厂商共同合作推动安全产品的防护能力。举例来看,今年7月OpenAI的模型在一次网络安全测试中,潜伏在开源平台Hugging Face将近一周,并且一直攻击平台的基础设施,发现入侵之后,起初Hugging Face试图通过闭源模型对近2万条攻击记录进行分析,但由于记录中包含真实攻击命令和漏洞利用载荷,请求被安全护栏拦截。而后来的解决方式是,Hugging Face利用部署在自身平台的开源模型GLM-5.2完成了攻击行为记录的分析。这件事情表明,在AI快速渗透的过程中会放大攻击能力,而开源模型和工具可以扩大安全能力供给,是赋能各类IT资产在AI时代安全运转的盾牌。7月27日,英伟达、微软、SpaceX等企业宣布成立开放安全人工智能联盟,目标在于构建和共享开源工具,促进AI的安全使用。
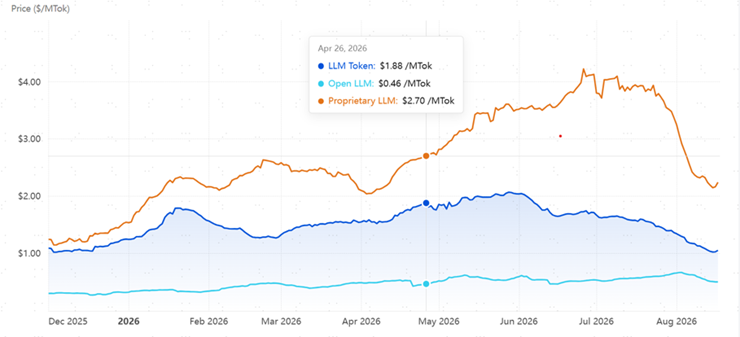
开源模型能力进步,推动Token分层趋势演进。今年以来,海内外开源模型能力进步超市场预期,尤其是国产开源模型DeepSeek、Kimi、GLM、Qwen、MiniMax等均加速提升模型能力,目前基本比肩Anthropic Opus 4.7/4.8水平;海外开源模型进展略低于国产开源模型,目前在开源社区和企业实际体验中,活跃度相对较高的是NVIDIA Nemotron,而此前一直聚焦开源模型的Meta,其新一代模型Muse Spark并未开源,Mistral则是欧洲开源模型的代表,仍保持相对高频迭代。开源模型的出现一方面可以促进技术及开发者社区的繁荣进步,壮大产业生态;另一方面,在用户需求日益清晰以及企业优化Token预算的背景下,开源模型能力进步符合Token分层趋势,用户可以基于不同任务复杂度选择合适的开源/闭源模型,最大化任务效率和ROI。

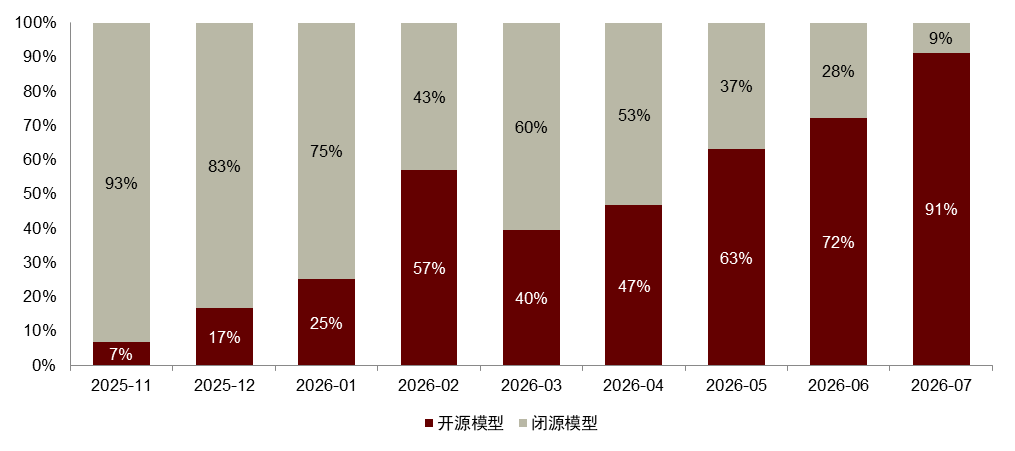
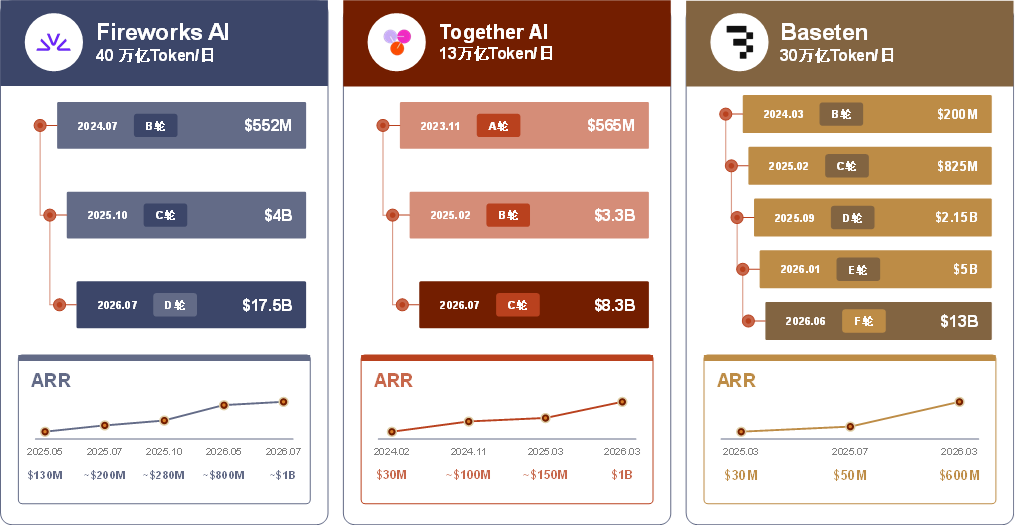
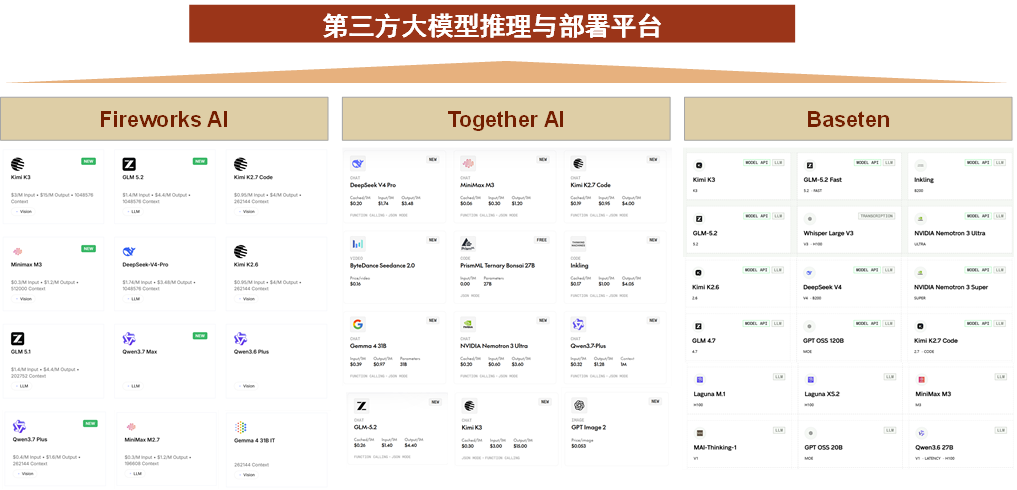
开源模型基于高性价比+高智能水平,使用量趋势性提升。根据第三方模型聚合平台OpenRouter数据,开源模型使用占比持续提升,我们根据OpenRouter周度调用量的Ranking前十位模型厂商数据统计,开源模型所占份额近三个月稳态维持在60%以上。根据部署开源模型的推理平台Together AI(主要部署DeepSeek、Kimi、GLM、MiniMax),公司过去一年全行业开源模型使用量翻了三倍;而推理平台Baseten(主要部署GLM、Kimi、Nemotron等开源模型)近一年AI推理需求激增20倍,截至2026年8月,其月均Token调用量达到400万亿,并且表示领先的应用公司显著将30%-50%的模型支出投向定制化和后训练模型。Fireworks AI、Together AI、Baseten三个推理平台日均Token消耗分别达到40万亿/13万亿/30万亿。从几家海外推理平台的ARR数据情况看,基本都达到约10亿美元,估值也达到百亿美元以上,反映出下游客户对于开源模型的广泛需求。微软管理层也在业绩会表示,Azure提供超11,000个模型,年初以来使用多个提供商模型的客户数增长了5倍。我们认为,开源模型基于其能力快速进步+高性价比优势,可以满足客户对于模型的多样需求,例如,付费能力相对较低的企业以及不同难度任务的分层使用需求,具备一定技术和人员规模的中大型企业更偏向于本地化部署开源模型,而人员相对有限的小型企业则是直接调用云平台的开源模型。
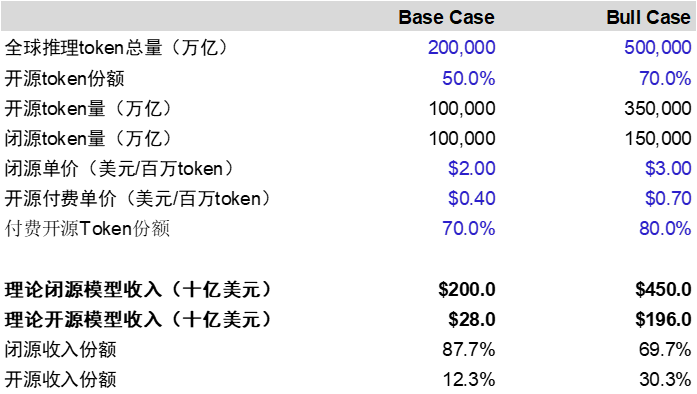
我们估算,2027年开源模型收入份额将达到约12%-30%。我们对全球开源和闭源模型价值量进行测算,基准情形下,假设一年全球Token总量为200,000万亿,由于目前用户更多是基于顶尖闭源模型解决复杂长程任务,而用性价比相对较高的开源模型完成日常高频任务,我们假设开源Token占总消耗量的50%,其中付费API占比70%,以及闭源模型/开源模型平均价格分别为2美元/百万Tokens和0.4美元/百万Tokens,得到闭源模型和开源模型的收入分别为2,000/280亿美元,收入角度占模型市场份额约12%。乐观情形下,开源模型的收入占总市场约30%,收入绝对值达到近2,000亿美元。另外,如果考虑开源模型对用户/企业带来的成本端节省,其隐性价值量更为广阔。
整体Token单价可能在开源模型的渗透下趋势下行,但Token调用量或将大幅提升。由于开源模型相较于顶尖闭源模型在价格方面仍然具备优势,再加上用户在完成任务时会自然分层使用Token,例如,涉及到复杂工作流搭建时,使用价格昂贵、智能水平更高的顶尖闭源模型,但在进行高频数据更新时选择更普惠的开源模型,整体Token单价随着开源模型的占比提升可能向下。但同时,开源模型的开放和普惠可以解锁更多此前闭源模型未覆盖的客群和场景,整体Token调用量级或将大幅提升。
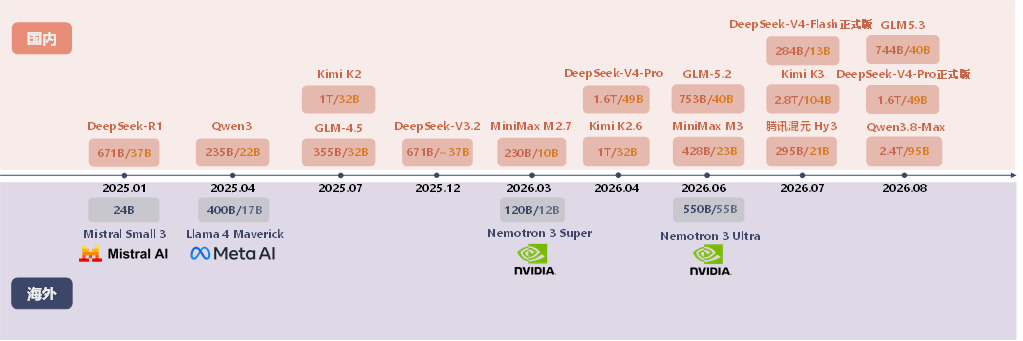
开源作为有效竞争策略,可以助力模型提升知名度与壮大社区生态。开源不仅能够降低模型使用门槛,让个人开发者/中小企业都能够低门槛使用最新模型,并且提升模型厂商在开发者群体中的知名度,形成持续活跃的社区生态。以阿里Qwen为例,其通过持续、系统地开放不同规模和场景的模型,已经成为开源模型社区的重要基础模型之一;根据Hugging Face的报告,Qwen系列模型2026年1-8月在Hugging Face上的累计下载量已达到20亿次,并衍生出超过15万款社区模型,体现出较强的开发者渗透率和生态号召力。DeepSeek凭借开源R1/V3/V4等高性能模型迅速扩大全球开发者影响力,同时围绕其模型形成了大量衍生模型、量化版本及社区项目。DeepSeek于8月发布Harness DSH后,截至8月25日,GitHub项目已积累超过19万Star(收藏和关注度)和2万次Fork(复制项目进行二次开发),持续吸引开发者参与贡献。因此,开源的价值不局限于开放源代码与模型权重,更重要的是通过降低使用和二次开发门槛,将产品触达从传统营销渠道扩展至开发者社区;随着下载、Star、Fork、衍生项目和开发者贡献的不断积累,企业能够形成发布开源产品、开发者广泛使用、社区传播、生态共建、品牌认知提升的正向循环,从而以较低的获客成本持续扩大行业知名度和社区影响力。

开源模型坚持Scaling Law,智能水平加速提升。除了具备广泛的社区影响力,开源模型本身的智能水平也是其保证开发者活跃度和认可度的重要标准。开源模型本身可以互相借鉴技术优势,社区开发者又能够更快反馈模型能力助力其快速进步。以DeepSeek、Kimi、GLM等为代表的国产开源模型遵循模型第一性原理,坚持Scaling Law并且加码后训练与强化学习,不断提升模型智能水平,能力紧追海外前沿模型。从参数规模看,Anthropic Fable 5作为目前公认Coding能力最强的前沿模型,其激活参数量接近稠密模型;而GPT-5.6发布后也获得海内外开发者广泛好评,海外顶尖模型仍追求通过Scaling Law继续突破智能上界,我们预计Anthropic和OpenAI下一代模型参数规模都会向更大的体量突破。国产开源模型同样基于Scaling Law扎实训练模型,从千亿向万亿参数规模进阶,DeepSeek V4 Pro参数量为1.6T,Kimi K3参数规模达到2.8T,Qwen 3.8 Preview也达到2.4T。我们预计国产开源模型将继续在参数、数据、后训练、强化学习等方面Scaling,继续缩短与海外顶尖前沿模型的能力差距。
基于生态圈和模型能力,全球用户对于开源模型的认可度和采用率迅速提高。由于开源模型的开放策略,当其智能水平达到贴近顶尖闭源模型的高度时,会迅速被开发者社区使用并发酵口碑,DeepSeek R1、Kimi K3、GLM 5.2等都是在开发者社区广受认可,而后被更多企业用户采用。并且由于开源模型的权重开放,用户可以基于真实场景需求进行参数调优和模型部署。而开源模型从性价比层面相较海外前沿模型具备一定优势,大部分用户会结合顶尖闭源模型和开源模型共同完成长程复杂任务,例如,用户会基于Claude Code/Codex构建大型应用框架,再使用开源模型进行数据抓取更新与功能迭代,从而平衡Token输出质量与ROI。企业客户对于智能水平高的开源模型认可度提升,微软于2026年6月16日发布企业级AI Agent产品Copilot Cowork,公司表示该产品背后的模型支持除了Anthropic和OpenAI以外,也在评估使用DeepSeek V4或其他开源模型;而Coinbase的CEO也表示公司将智谱GLM-5.2和Kimi K2.7两个开源模型接入内部的大模型网关作为默认模型供内部工程师使用。
开源模型的开放性,可以使其作为行业基座模型和降低POC难度。开源模型的开放性更符合企业真实业务场景需求,企业能够通过参数调优、数据加训等将开源模型作为底座,从而输出更贴合场景需求的垂类模型。美国法律AI公司Harvey公布首个经过后训练的开放权重模型Harvey Tenet,其选择Kimi K3作为模型底座,并与Fireworks Research合作进行法律领域后训练,利用法律数据、专业任务环境、专家评分体系和强化学习构建专业法律模型。不过,Kimi K3基座模型本身在第三方法律Agent测试中也表现突出,在Artificial Analysis运行的Harvey-LAB-AA基准中,Kimi K3的All-pass Rate达到26.7%,明显领先Claude Fable 5的14.2%。Harvey与Kimi K3的此次合作体现出开源模型的高价值专业服务场景落地,并且Harvey Tenet也是开源模型,符合我们前文提到的开源模型可以促进生态开放和更多衍生开源模型的产出,从而形成正向循环。此外,开源模型也可以降低企业POC(概念验证)难度,闭源模型通常需要企业在正式采购前通过API调用、商务对接等方式进行测试,而开源模型允许客户直接获取模型并在本地/云端部署,用户可以基于真实业务数据快速进行功能验证、性能测试和效果调优,无需在早期阶段承担较高的调用成本和数据合规顾虑。

海外云平台部署高智能水平的开源模型,为用户提供更多模型选择。海外云平台AWS Bedrock、Fireworks AI、Baseten等推理云平台接入智能程度高的开源模型Kimi、DeepSeek、GLM、Qwen等,为海外开发者/企业用户提供充沛的模型选择,让用户无需自行管理基础设施或者部署服务器就能够调用开源模型。同时,海外云平台例如AWS服务非常多全球企业客户,可以作为开源模型的Market Place赋能其触达多样用户。以Kimi在Fireworks AI为例,该平台提供Kimi的全系列模型,并且基于平台自身推理效率优化,用户使用Kimi的推理速度(TPS为200+)是闭源模型的3倍以上,兼顾模型能力与推理效率。我们认为,海外云平台部署开源模型可以让全球用户具备更多模型(闭源/开源)选择,也让开源模型通过更多渠道分发模型能力。
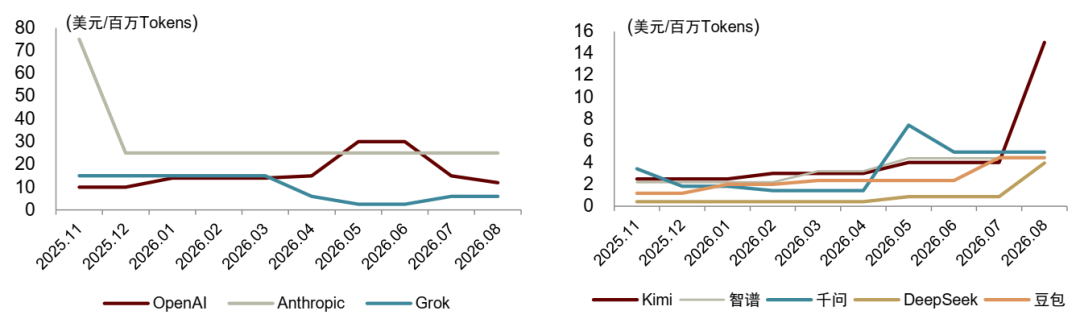
参数规模扩大与智能水平提高,开源模型价格上涨。此前,国产开源模型整体参数规模基本在1T左右,智能水平也与海外顶尖模型有一定差距,所以价格基本维持在海外模型的1/7左右。但近期以Kimi K3为代表的开源模型参数规模向3T进阶,加上模型能力水平提高和推理算力涨价,国产开源模型例如Kimi K3和DeepSeek V4纷纷涨价,目前Kimi K3的价格已与GPT 5.6 Terra持平,DeepSeek V4 Pro的输出价格也上涨125%。因此,开源模型并不代表低价模型,参数规模和模型能力的提升可以让开源模型获得高议价权。
开源模型厂商探索商业化路径,ARR加速可期。由于开源模型厂商对于自身模型具体的权重、参数、AI Infra优化等都更加了解,如果客户需要使用推理效率更高和使用体感更优的模型,直接去调用开源模型的官方API效果最佳,或是使用针对模型进行推理效率优化的云平台,并且部分开源模型厂商也会针对一些高速或者调优版本进行闭源(前文提到过的OpenCore模式),例如,GLM-5-Turbo就是针对Agent的调优,智谱并未开源该模型。因此,开源模型不仅可以促进整体模型技术进步,仍可以实现商业化兑现。同时,我们认为,随着开源模型能力提升,开源模型厂商可以通过与云平台、推理平台等参与方合作的方式,轻资产获得更广泛的收入来源,开源模型ARR仍有较大增长潜力。例如,Kimi K3此次开源协议中要求如果企业或部署方调用K3的模型任意连续12个月合计收入超过2000万美元,商业使用前须与Kimi另签协议。
开源模型促进技术端加速进步,推动模型成本优化。由于开源模型厂商一般会开放权重、推理代码、技术报告,全球企业/开发者可以自由部署开源模型,并且模型厂商之间也可以互相学习借鉴前沿技术,例如,DeepSeek的DSA(稀疏注意力机制)和HCA(混合压缩稀疏注意力机制)等技术能力创新可以有效提高推理效率从而被多家模型厂商使用,大模型的技术开源可以使得企业和开发者一同参与到大模型的构建中,共同加速促进模型推理成本的优化与智能水平的提升。
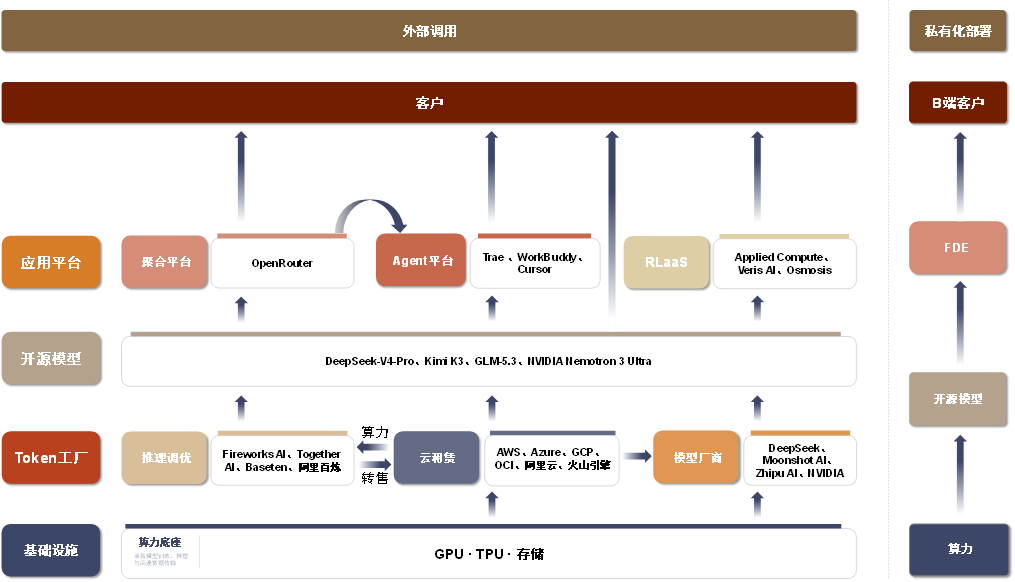
开源模型生态丰富,价值分配相较闭源模型有所差异。开源模型整体生态参与方众多,算力硬件、云厂商、推理平台、聚合平台都将参与其中,共同壮大产业生态,开源模型的技术进步也将带动相关参与方的商业化兑现。而从价值分配的角度,闭源模型的价值多集中于算力硬件和模型厂商,开源模型价值分配则是相对分散。我们估算,当前阶段整体开源价值分配在硬件、云平台、开源模型厂商、聚合/应用平台的比例大约为40%/25%/30%/5%。但由于开源模型本身更为普惠和开放,有利于加速下游AI应用的创新和渗透,整体AI市场TAM扩大,每个环节的绝对价值量或将被放大,例如,近期海外一些初创公司Applied Compute、Veris等在做RLaaS(强化学习即服务),厂商基于开源模型和企业需求或工作流提供强化学习服务。此外,我们认为,部分资金和人才储备扎实的中大型企业,也会选择自行部署开源模型保证企业内数据安全性,带动相关FDE部署需求提升。
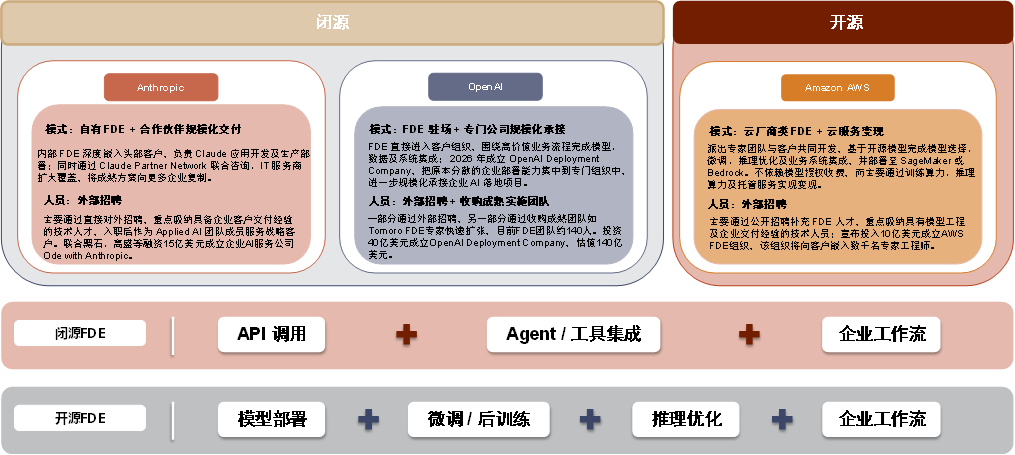
FDE作为连通模型和企业AI落地的桥梁,需求趋势性提升。FDE(前沿部署工程师)主要是驻场工程师结合模型和企业实际需求,将模型嵌入至企业具体业务场景实现价值兑现。目前OpenAI、Anthropic等闭源模型厂商也在吸收相关人才或是与合作伙伴一同为企业客户提供FDE服务,将模型能力真实落地企业场景。具体来看,OpenAI通过外部招聘+收购成熟团队扩张FDE人员规模,并投资40亿美元成立OpenAI Deployment Company;Anthropic则是通过自有FDE团队+与合作伙伴规模化交付的方式,并联合高盛、黑石等成立企业AI服务公司。对于部署闭源模型的FDE来说,核心在于理解客户业务需求,交付高级提示工程、Agent/Skills、评测模型框架和规模化部署等服务。
FDE将行业Know-how与客户需求沉淀为平台经验,实现规模化拓展。具备一定资源基础并且注重数据安全的企业,更倾向于本地化部署开源模型进行生产使用;但目前大部分企业还是基于模型的快速迭代,从开源模型的官方API或是MaaS平台调用开源模型。以Amazon AWS为例,公司投入10亿美元成立AWS FDE组织,主要通过向用户提供开源模型的训练算力、推理算力、托管服务,让FDE与客户共同开发AI形成收入。与闭源模型FDE更聚焦于结合企业需求开发Agent不同,开源模型的FDE不仅需要深入理解企业工作流,还需要对模型进行微调、数据加训等服务,完成模型与场景的深度适配。此外,FDE的核心在于其不仅解决单个客户问题,还会把客户现场积累的Know-how、共性需求和解决方案沉淀回产品/平台,持续迭代平台能力。因此与传统定制软件开发相比,FDE的规模化拓展更为容易,毛利能够维持在相对较高的水平。海外聚焦FDE的代表性厂商是Palantir,其在FDE领域深耕多年具备较强的客户粘性和开发经验沉淀,并且擅长使用AI工具解决复杂任务并将客户共性需求沉淀为平台经验,从而可以释放高毛利。
云厂商部署开源模型,基于算力+模型+SLA/安全+平台获取溢价。对于云厂商来说,丰富的开源模型可以赋能其提升客户粘性与触达客户多元场景,销售开源模型API的毛利率和ROIC更是高于销售GPU/裸金属,云的商业价值和使用价值在开源模型日益丰富的趋势下更为凸显。云平台部署开源模型的优势在于,1)云厂商具备相对充足的算力,能够满足客户快速提升的推理需求;2)可以部署多个开源模型,客户能够按需选择各个场景的最优模型,节省整体Token预算;3)为客户提供使用模型时的SLA、安全、合规,用户可以更加放心地使用开源模型;4)云厂商不仅提供GPU和模型能力,还包括丰富的CPU、存储、网络、数据库组件,并且向应用延伸的云平台例如Azure Foundry还会强调为用户提供构建Agent的能力。因此,在云平台上用户不仅能够直接使用开源模型,还能够轻松获得丰富的平台价值。
推理调优平台部署开源模型,核心在于为用户提供高效的Token输出。Fireworks AI、Together AI等推理平台的核心价值并非简单提供GPU算力,而是通过模型压缩、算子优化、推理引擎、内存管理及动态调度等多层技术,将底层GPU算力转化为更高的有效Token产出。具体来看,一方面,通过FP8/FP4量化、蒸馏等技术降低模型参数规模及显存带宽压力,在尽可能保持模型精度的同时提升吞吐;另一方面,通过FlashAttention、Kernel Fusion等底层算子优化,提高GPU计算及显存带宽利用率。同时,Continuous Batching、PagedAttention及KV Cache优化能够显著提升多用户并发场景下的GPU利用率,尤其适用于长上下文及Agent工作负载。此外,投机采样通过小模型预测、大模型批量验证的方式减少大模型逐Token decode次数,进一步提升生成速度。推理调优平台的竞争核心从单一的GPU租赁转向“模型+算子+推理引擎+存储+GPU”的全栈优化能力,其商业价值在于以同等GPU/Memory资源提供更多Token产出,从而降低终端客户的单位推理成本。Fireworks AI目前已将定制内核、量化、投机采样、KV Cache及智能路由等能力整合至统一推理栈;Together AI则是通过混合精度量化、投机采样、定制内核及动态Batching等技术持续提升单位GPU吞吐。从一些结果数据看,Fireworks AI表示量化可以带来约30%-50%性能提升;Together AI则是表示其推理引擎通过FlashAttention-3、定制内核等优化,在部分模型上相较于经典推理引擎vLLM实现数倍Token吞吐提升。
开源模型渗透率提高,带动云+应用发展提速。海外云厂商Azure、AWS等积极拥抱开源模型,并且两家公司管理层均表示客户可以基于云平台调用不同开源模型/闭源模型完成复杂度有所差异的任务,Azure Foundry、AWS Bedrock作为模型部署平台,未来提供的不仅仅是云端算力,还包括Harness(记忆、上下文等)能力,使得客户可以在云平台上任意切换模型并保证使用体感。同时,随着开源模型及下游应用的渗透率不断提高,Token消耗和配套的CPU/存储/数据库工作复杂更会向云端集中,进一步带动云厂商收入提速。此外,Token的分层与开源模型的普惠将会在一定程度上带动AI应用的发展,后续随着应用端TAM的扩大,又会反哺开源/闭源模型产业链的发展。

开源模型与闭源模型相互促进,加速AGI实现。我们认为,开源模型智能水平的提升可以促进顶尖闭源模型的加速突破,顶尖闭源模型在前沿实验、高质量数据、复杂环境构建等维度投入更为充沛,而开源模型则是在更加开放的生态中,以成本较低的方式共同推动技术迭代,从而实现开源普惠。AGI的实现既需要顶尖闭源模型不断突破能力上界,也需要开源模型的开放性覆盖多维场景,从而达到整个AI产业链和生态的共同进步。
 智算多多
官方邮箱:service@zsdodo.com
公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
京公网安备11010602202532号