



 智算多多
联系我们

官方邮箱:service@zsdodo.com

公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
关注我们

公众号

视频号
◎2025 北京智算多多科技有限公司版权所有 京ICP备 2025150592号-1  京公网安备11010602202532号
 这可不是OpenAI自说自话。
SemiAnalysis钻进实验室实测了一趟,写下的结论是——
Jalapeño把他们此前测过的每一颗英伟达、AMD、谷歌的芯片,全干趴下了。
差距有多大?英伟达最新那颗Vera Rubin吃掉的电,够喂将近三颗Jalapeño。
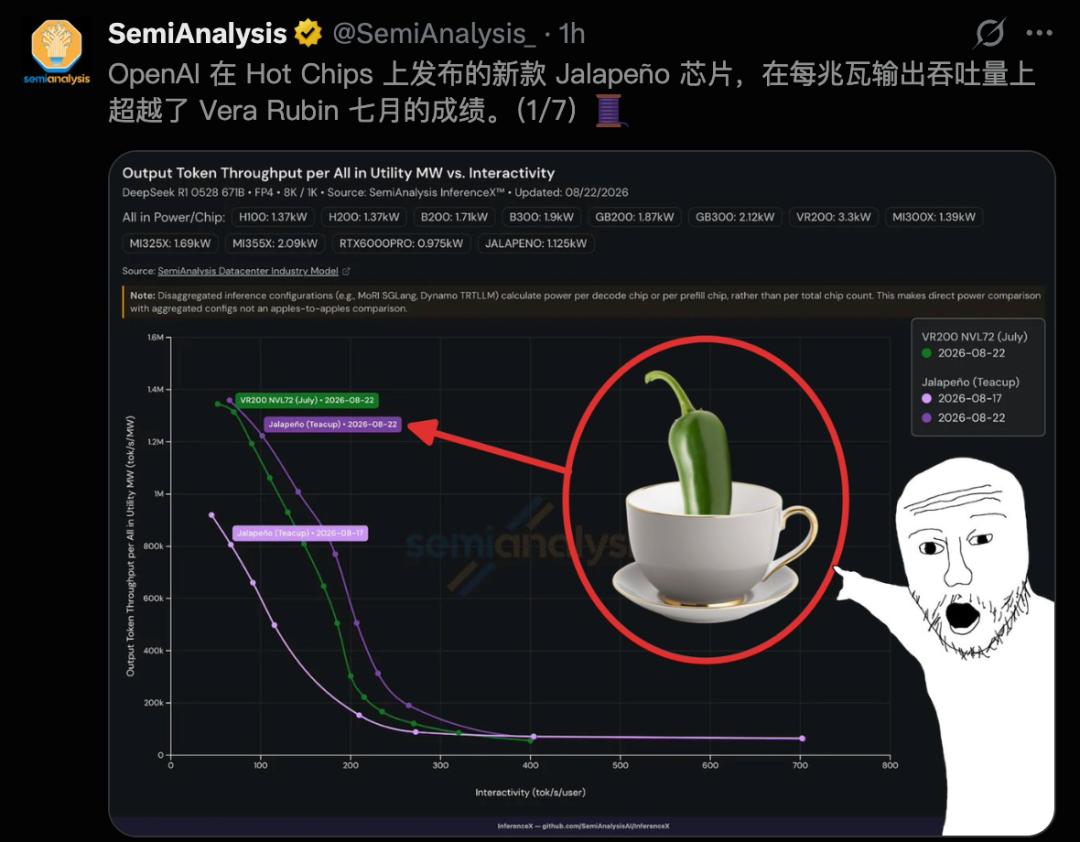
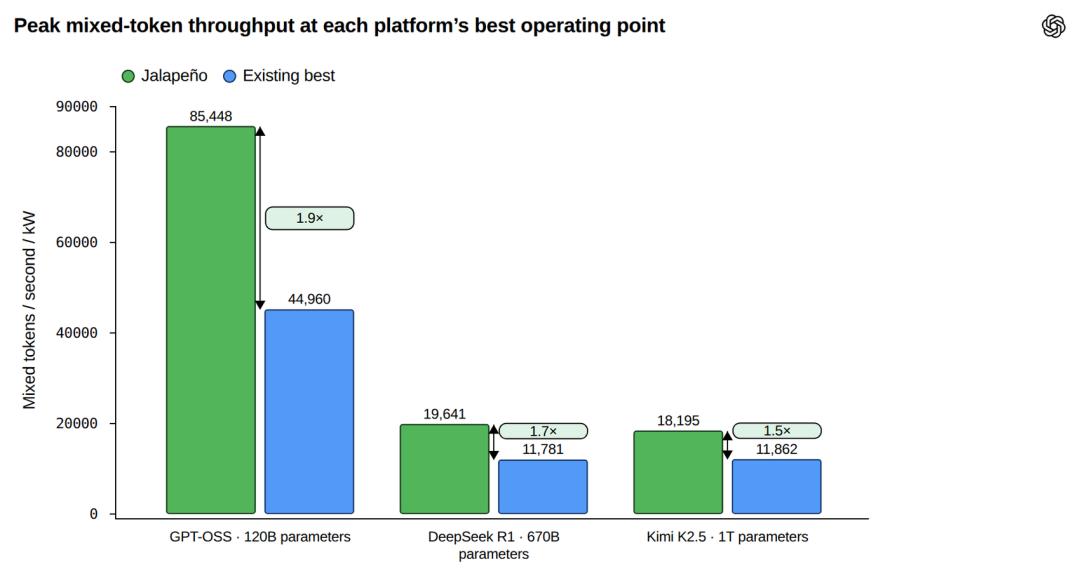
测试中,OpenAI挑了三个公开模型来跑:GPT-OSS 120B,还有一款670B和1T的模型。
这一轮测试,覆盖了从中型到万亿参数的MoE架构。整体结果如下:
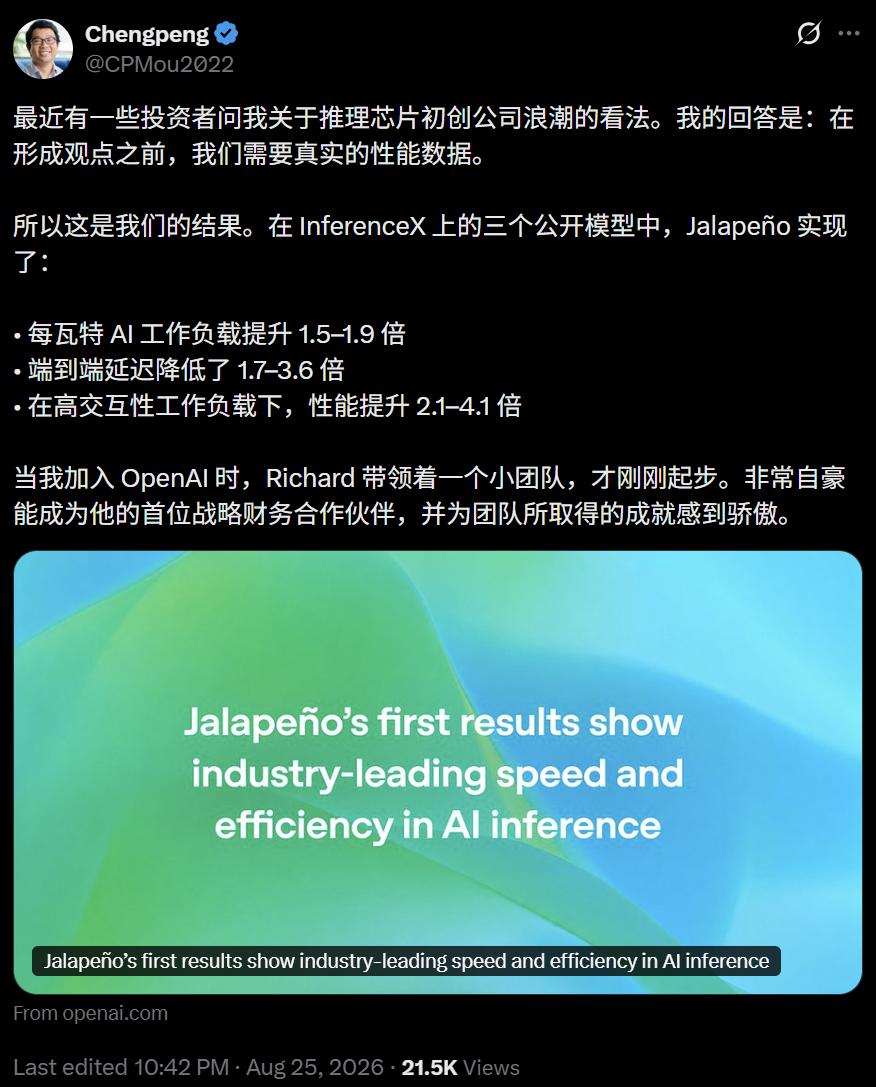
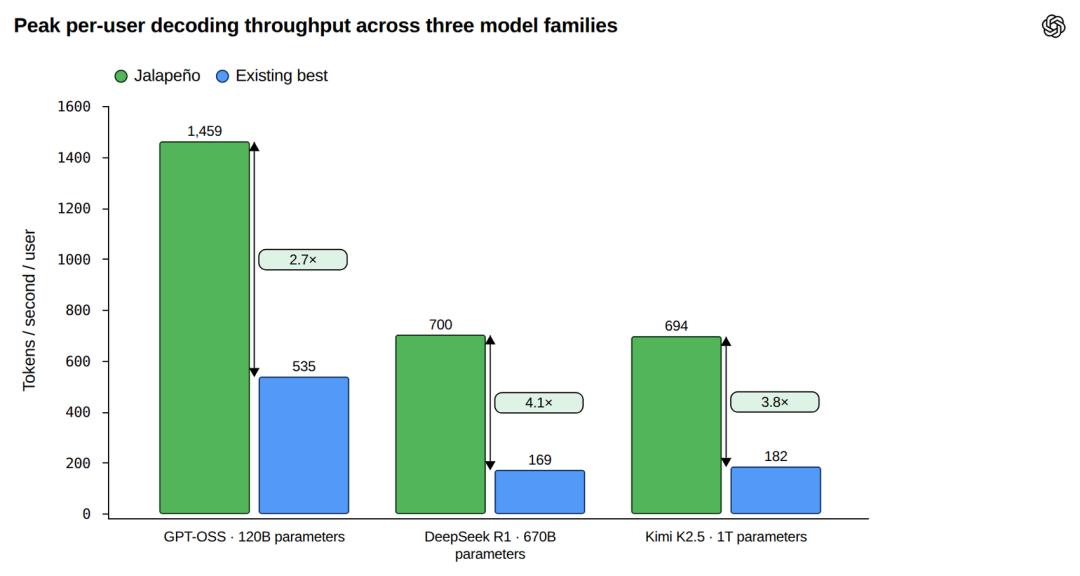
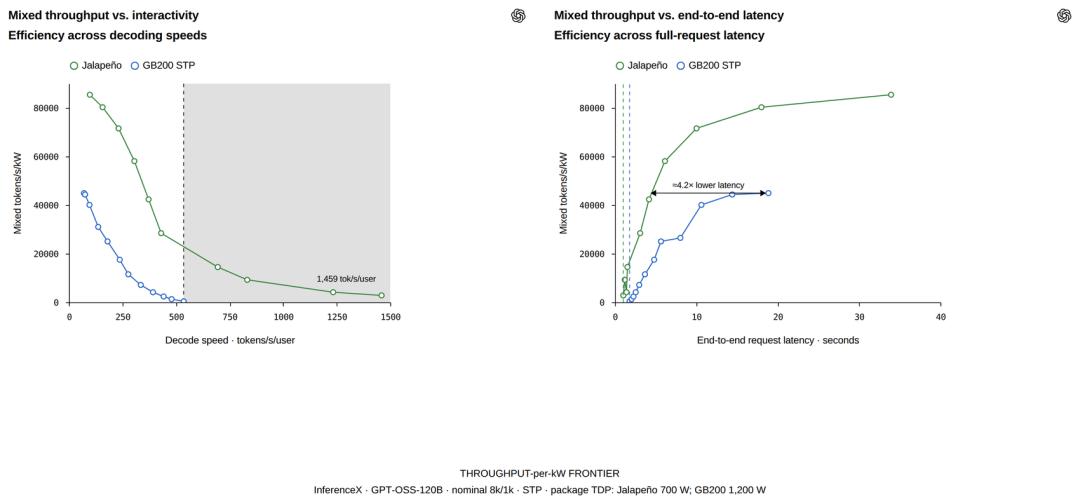
前面提及的1459个Token/s,是在GPT-OSS 120B上测的。
换算成出词间隔,两个Token之间只隔0.69毫秒。
人正常朗读一秒钟大概吐五六个字,而它一秒甩出1459个,眼睛跟不上,屏幕也刷不过来。
1.65秒对5.99秒的那四秒差距,放在聊天里还能忍,放到Agent身上就是另一回事,因为一个任务要连着走几十步,差值是要乘上去的。
然后说那个全网都在转的104.3倍。
它的准确意思是,把GB300推到自己最快的解码速度,也就是每秒169个Token,在那一个点上,Jalapeño的吞吐是它的104.3倍。
三个模型上都是这个走势,GPT-OSS到53.7倍,1T模型到56.1倍。
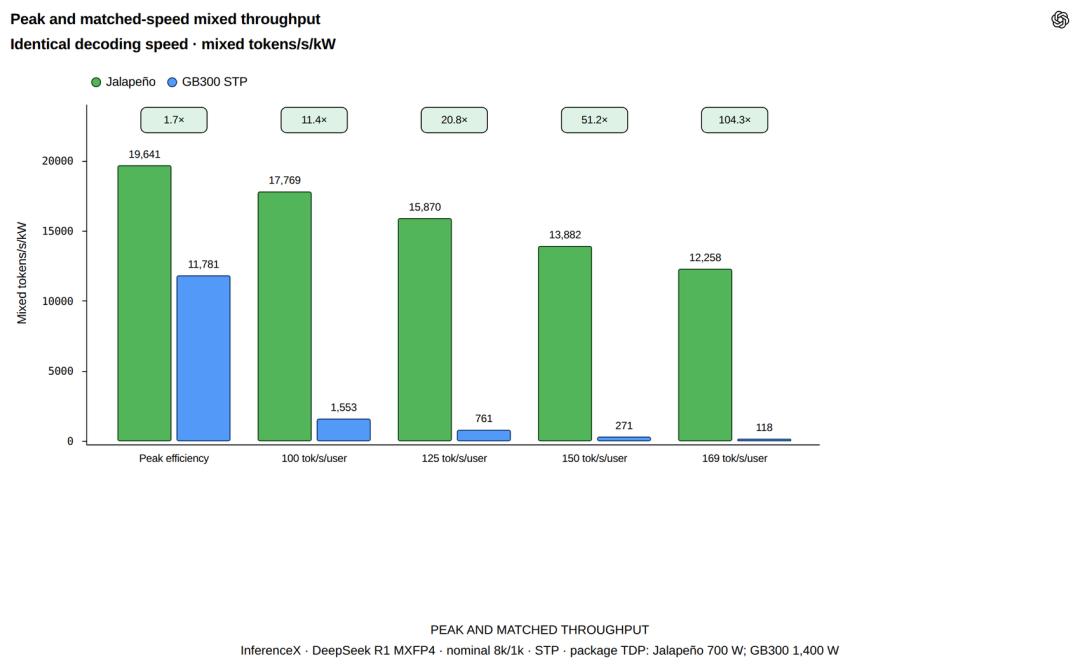
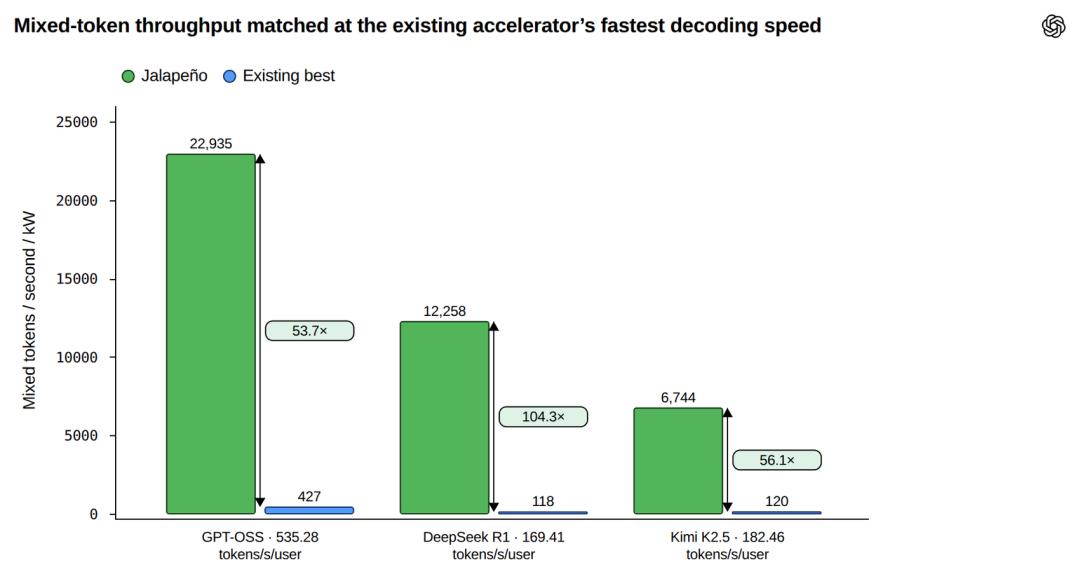
换句话说,对手跑到极限开始喘的地方,正是它还在从容巡航的地方。
如果按各自最好的工作点算峰值,差距会温和很多,三个模型上分别是1.9倍、1.7倍和1.5倍。
SemiAnalysis这边,则是把供电、散热、网络全算进去,然后再摊到每颗芯片头上。
结果,Jalapeño每颗1.125千瓦,GB200是1.87千瓦,而Vera Rubin是3.3千瓦。
在这个口径下跑GPT-OSS,Jalapeño每兆瓦每秒吐出约5300万个Token,GB200 NVL72只有约1000万。
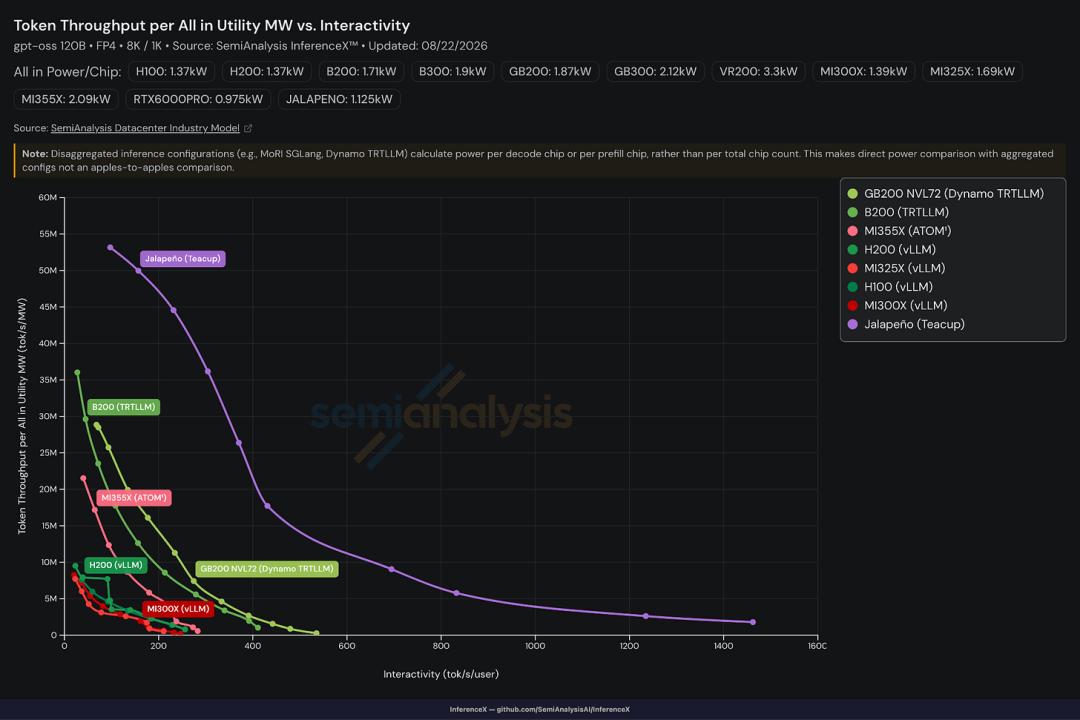
成本方面,每芯片每小时的总拥有成本,Jalapeño是1.56美元,跟H100的1.55美元几乎一样,而Vera Rubin是3.61美元。
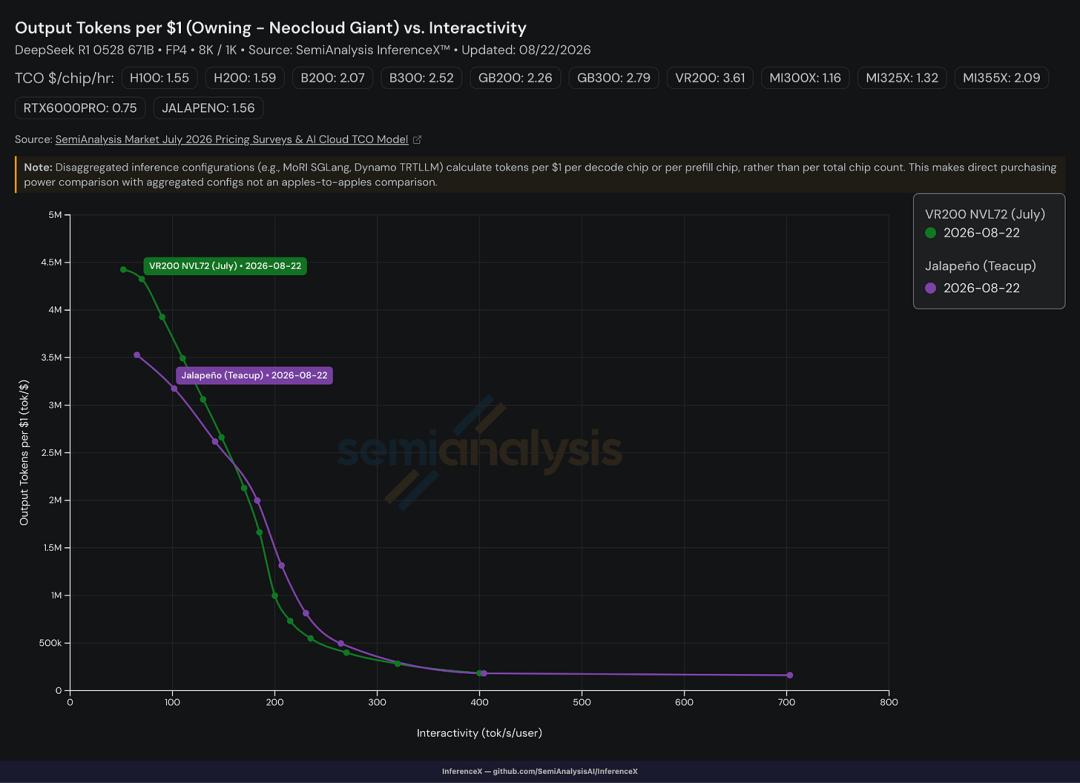
最要命的是,这些成绩还不是Jalapeño的全部实力。
它连投机解码和Token预测都没开,也没做prefill和decode的分离部署,而图上其他每颗芯片跑的都是各自最优配置,该开的优化一个不落。
SemiAnalysis估算,光投机解码这一项就能把每Token成本再压掉2/3以上。
这么一颗东西,从设计到流片OpenAI只用了九个月。相比之下,业内常见的时间是18-36个月。
做过ASIC的都知道,这个周期里最磨人的活是验证。仿真得一轮轮重跑,改一个地方就得从头再来。
OpenAI之所以能「开挂」,是因为它把自家最强的模型请进了流片室——
协助开发Jalapeño的模型叫GPT-Astra,也就是外界一直在传的GPT-6!
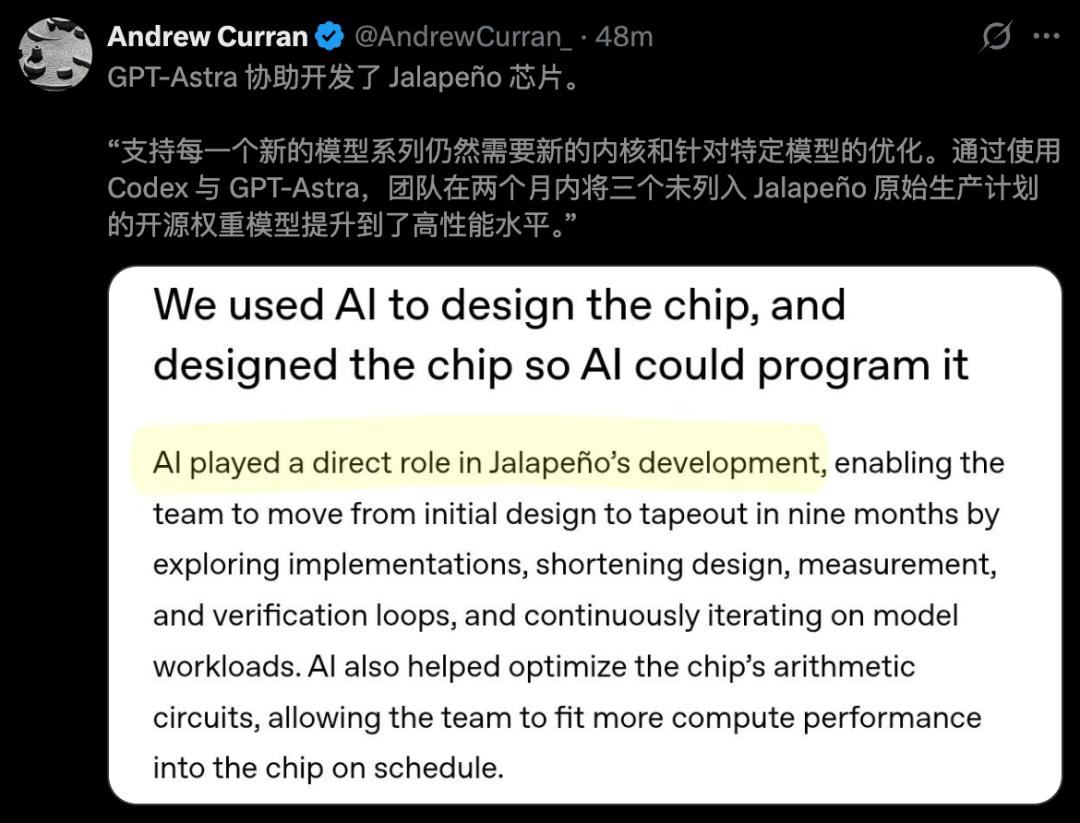
在整个过程里,GPT-Astra基本上成了团队的最强辅助。
它帮着探索实现方案,把「设计-测量-验证」这一整圈往死里压,还顺手微操了算术电路。
微操到什么程度呢?SemiAnalysis挖到的数字是,AI辅助设计让SIMD单元面积减少8%,矩阵引擎面积减少10%。
同时,这些模块在时序和功耗上都比初版更好。
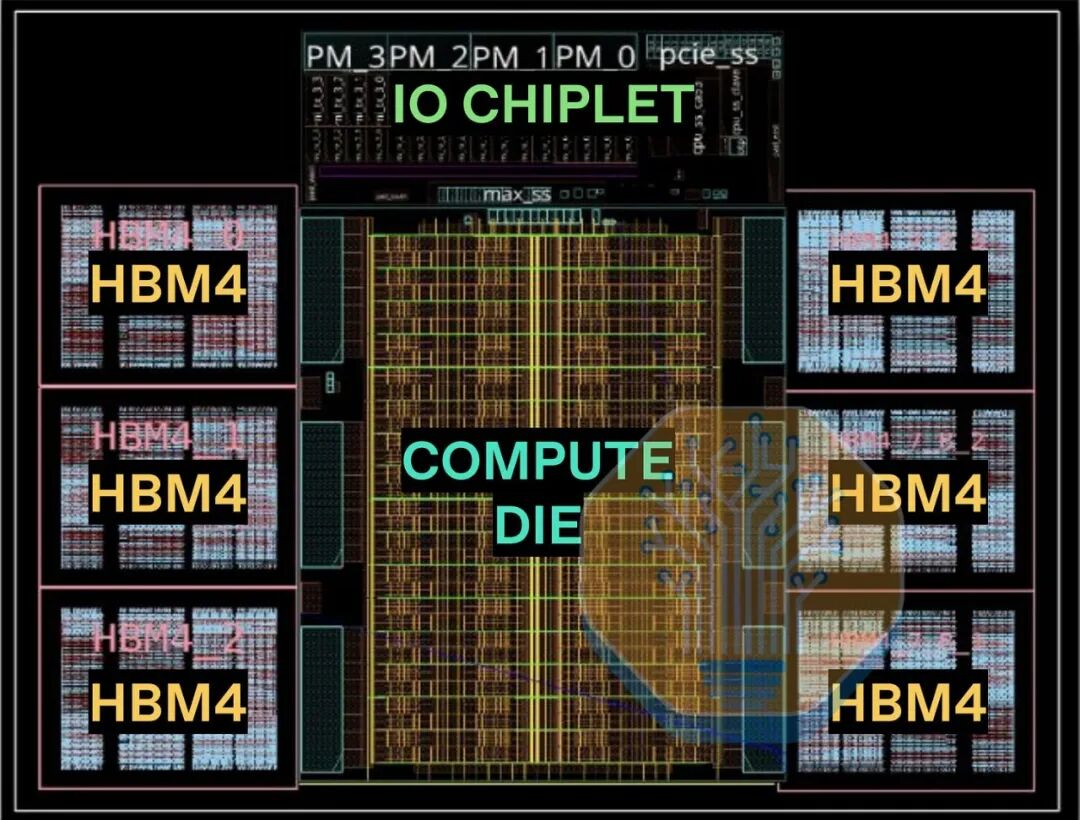
主计算die约840平方毫米,而EUV光刻机的掩模版极限是858平方毫米,这块硅离物理天花板只差18平方毫米。
可以说,基本上把光刻机能画的地方占满了,一点没留。
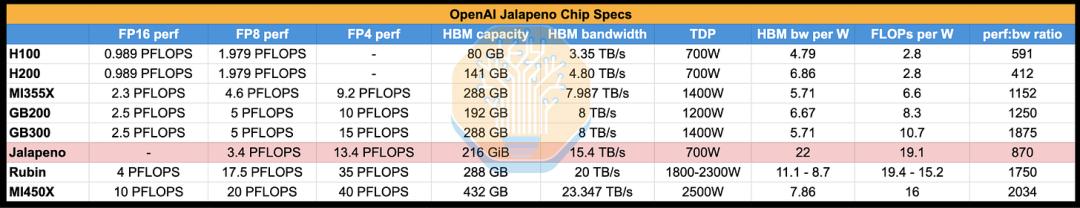
每瓦HBM带宽这一项,Jalapeño是22,第二名Rubin是11.1,GB300只有5.71。它比第二名高出整整一倍。
而每瓦FLOPs它是19.1,Rubin是19.4,两者几乎打平,可Rubin要烧1800瓦以上,Jalapeño只要700瓦。
这还只是用A0步进跑的。B0已经在晶圆厂里了,每瓦性能比A0还要再高约25%。
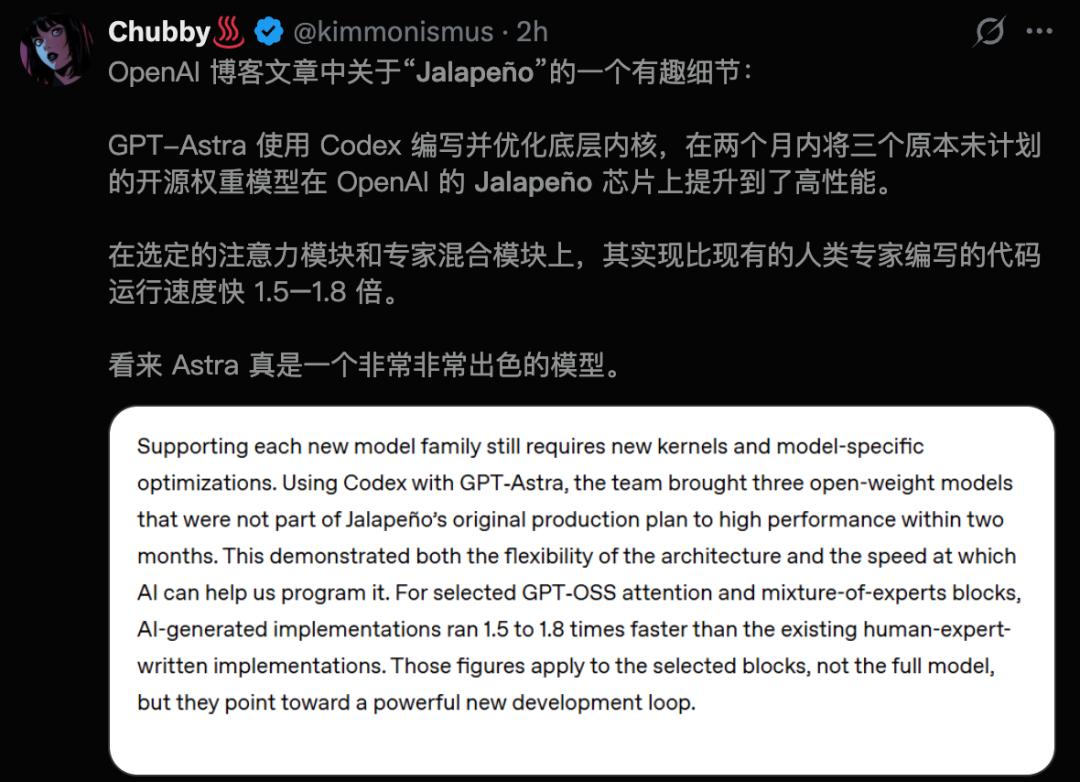
就这样,靠着Codex加GPT-Astra这对王炸组合,OpenAI在短短两个月内,把三个原本压根没排进计划的开源模型,一路爆改到了高性能状态。
更吓人的是,在最吃性能的「注意力」和MoE模块上,AI手敲的代码跑起来,直接比人类顶尖专家快了1.5到1.8倍。
AI设计芯片,芯片跑AI,AI再回头优化芯片上的AI。
这个飞轮,OpenAI已经转起来了。
一直以来,英伟达最深的护城河一直是CUDA。
将近二十年攒下来的软件栈养出了全世界工程师的肌肉记忆,换一次硬件就得推倒重来。
而SemiAnalysis在文章里下了一句相当重的判断,说CUDA的护城河可能已经死了。
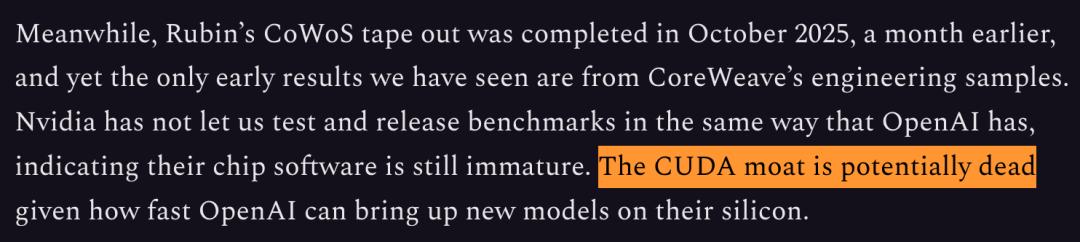
理由,就是速度。
他们还补了一个更扎心的对照,英伟达的Rubin其实比Jalapeño早一个月完成CoWoS流片。
可到现在为止,外界能看到的Rubin成绩只有CoreWeave工程样片那点数据,英伟达并没有像OpenAI这样把第三方放进实验室随便测。
所以问题出在软件起步的速度上,英伟达的硬件本身没毛病。
而从零开始甚至还让OpenAI占了便宜,不用背历史包袱,架构可以完全按白纸来画。
SemiAnalysis最后那句写得很有画面感——
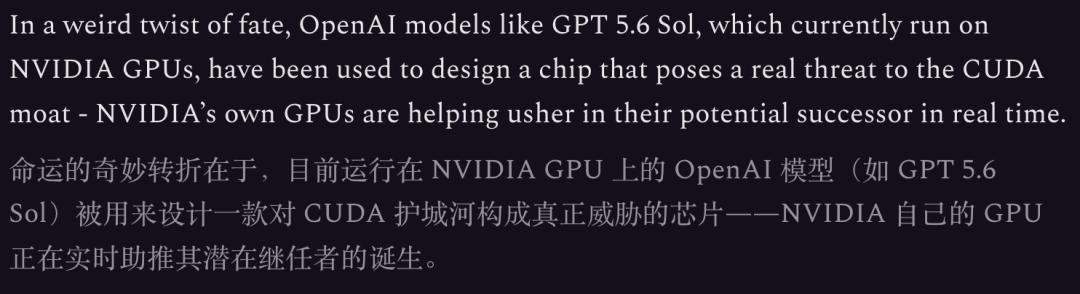
他们说GPT-5.6 Sol这类跑在英伟达GPU上的OpenAI模型,被用来设计了一颗真正威胁CUDA护城河的芯片,英伟达自己的GPU正在实时催生自己的「接班人」。
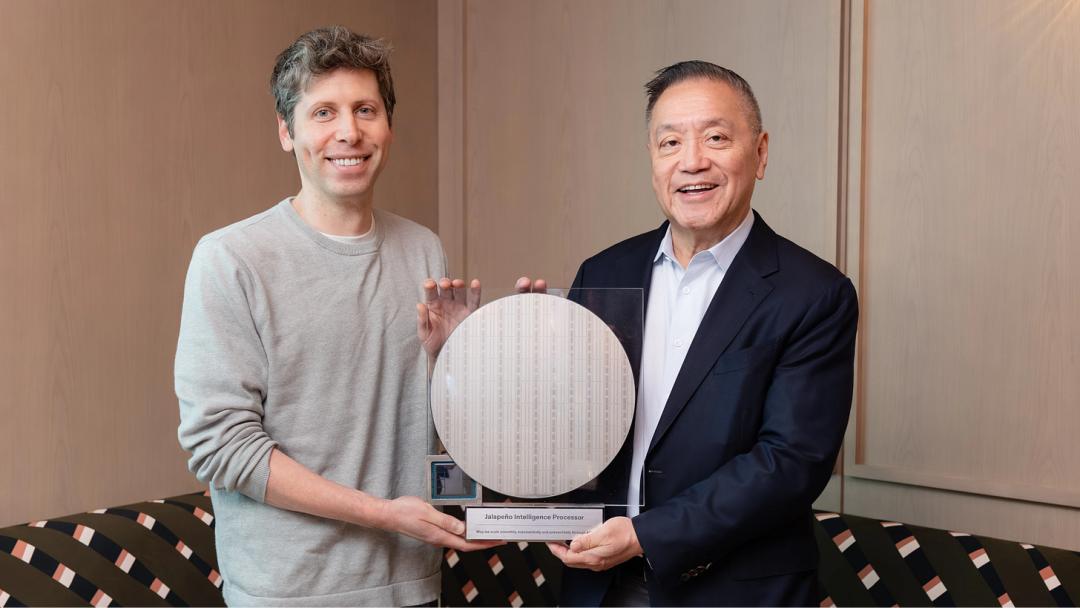
Jalapeño只是一条战线的第一枪。
去年10月,OpenAI和博通搞了个大动作,签了个10GW定制加速器的合作大单。
10GW量级,差不多相当于十座核电机组满发。
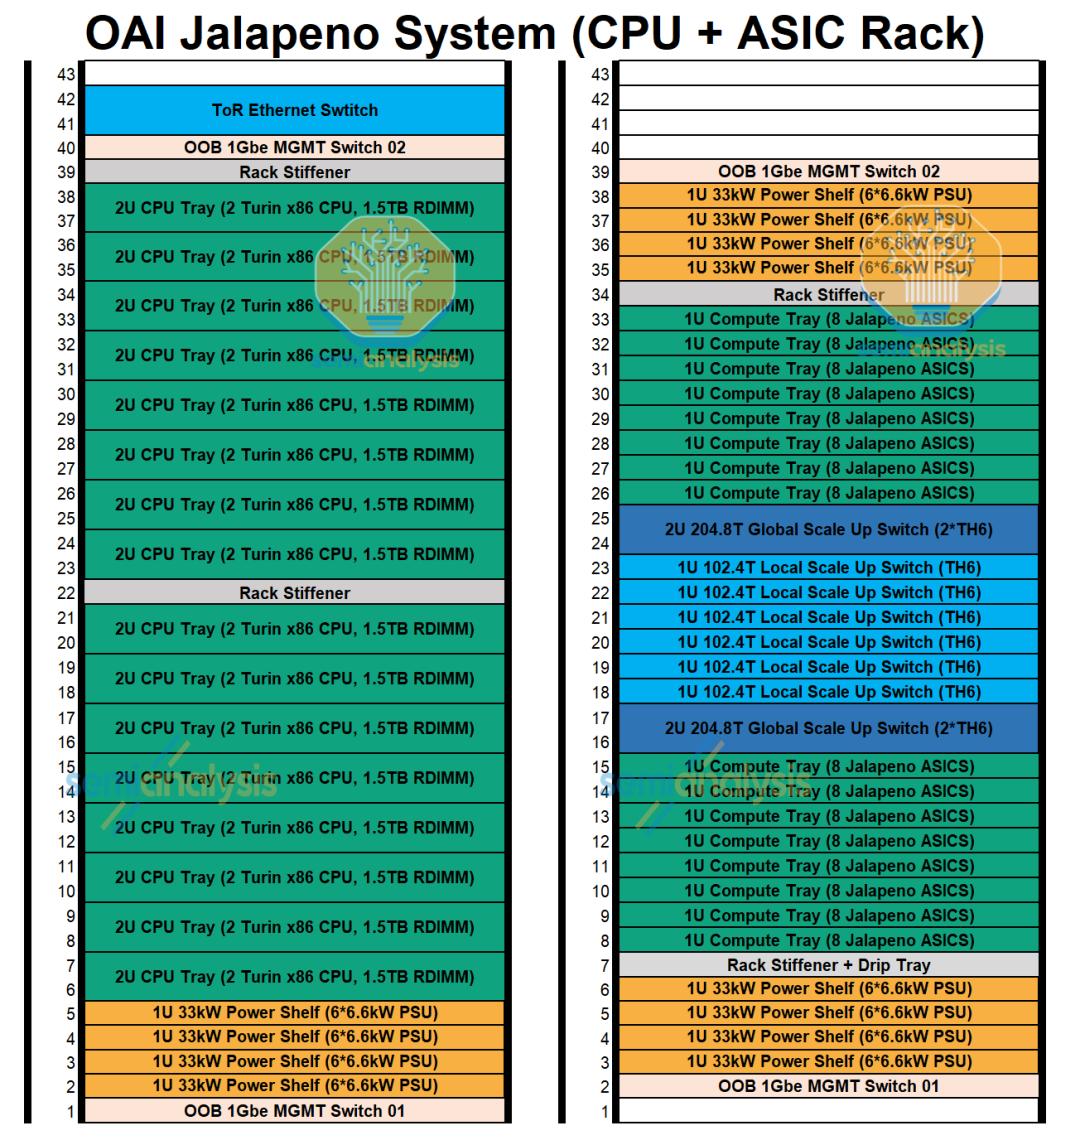
顺便说,装CPU的托盘叫Katsu日式炸猪排,装芯片的叫Vindaloo印度咖喱,交换机叫Chana鹰嘴豆,从日本菜一路辣到印度菜,这帮人是真想让你记住这套系统。
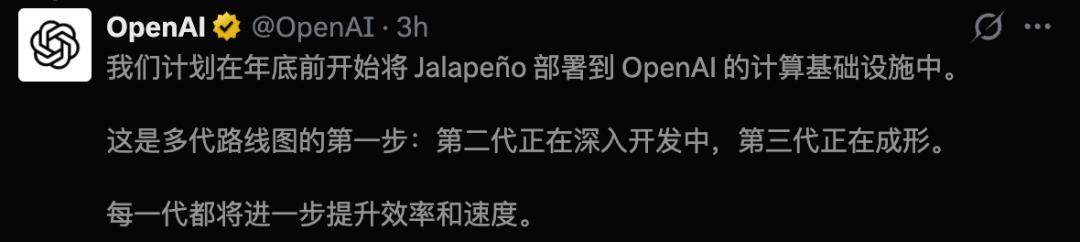
而Jalapeño只是路线图上的第一代,OpenAI在报告里写得明明白白——
Gen2已经在深度开发,Gen3也正在成形。
量产要到2027年才逐步爬坡,下一个里程碑是100兆瓦。
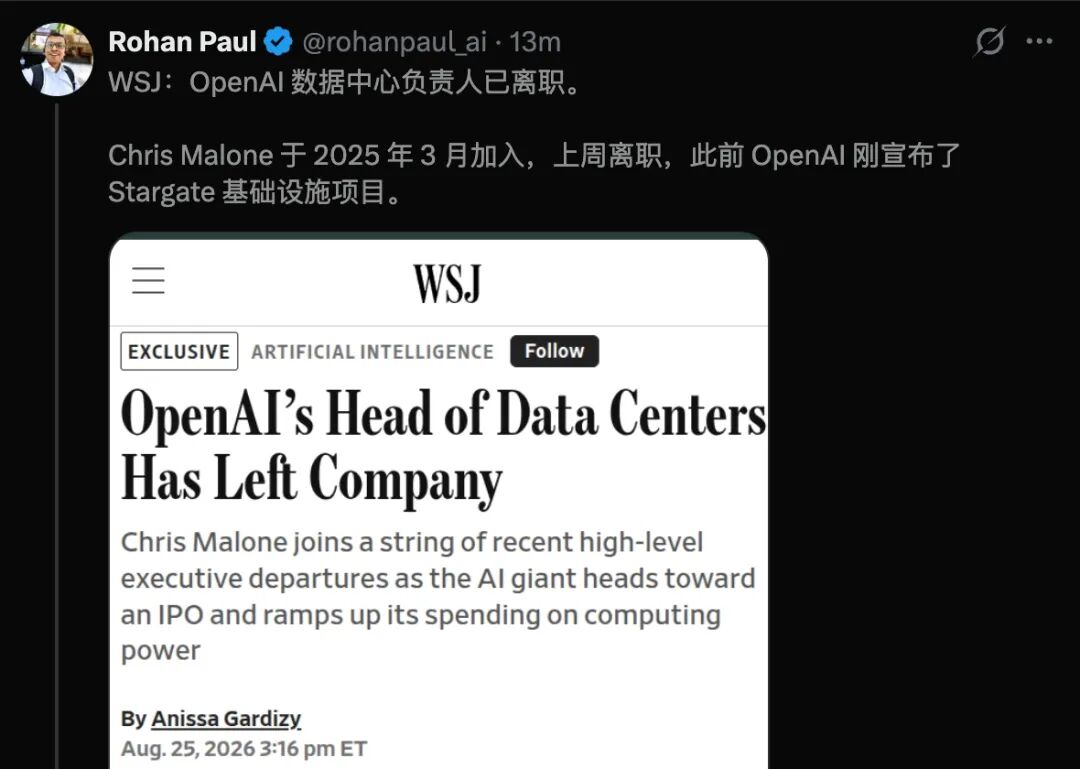
不过,就在今天,OpenAI还被爆出,数据中心大总管Chris Malone走了!
Malone可是负责「星际之门」(Stargate)的掌门人。
如今,IPO越来越近,在这个节骨眼上,失去算力基础设施的关键统帅,不禁让人对OpenAI背后的暗流涌动浮想联翩。
当然,一颗Jalapeño,还不足以掀翻英伟达。
但真正危险的信号在于,OpenAI已经把模型、芯片和软件拧成了一个加速飞轮。
今天的Jalapeño只是第一代,后面还有Gen2、Gen3,以及10GW的算力版图。哪怕核心高管离场,也挡不住这条路线继续向前。
英伟达依然坐在王座上。
只是这一次,替代者没有在门外排队,它已经跑进了机房。
英伟达的对手,终于开始自己造英伟达了。
 智算多多
官方邮箱:service@zsdodo.com
公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
京公网安备11010602202532号