



 智算多多
联系我们

官方邮箱:service@zsdodo.com

公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
关注我们

公众号

视频号
◎2025 北京智算多多科技有限公司版权所有 京ICP备 2025150592号-1  京公网安备11010602202532号
 Anthropic 发布了一份长达 186 页的最新《风险报告》。这份报告不仅评估了特定的 Claude 模型,还扩展到整个公司的运营情况,包括模型的应用、员工如何使用这些模型、安全系统的漏洞、AI 在下一代 AI 研发中的作用,以及这些因素综合起来可能带来的灾难性风险。

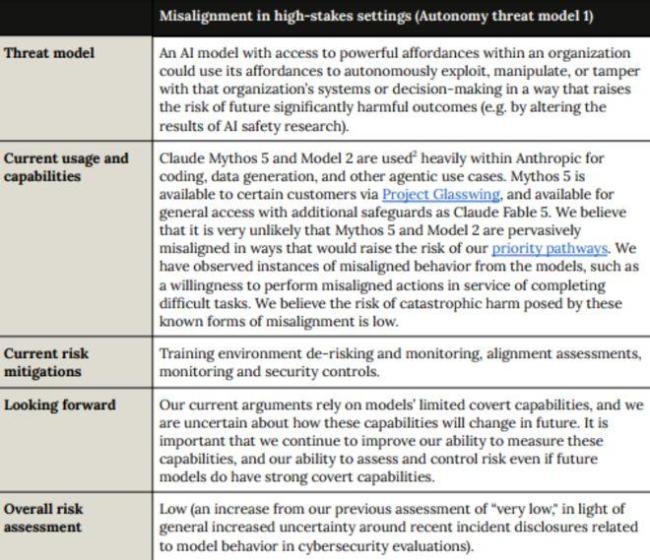
目前,Anthropic 认为整体风险“较低”。报告指出,Claude Mythos 5 和内部 Model 2 已经广泛用于研究和工程,包括交互式使用和持续运行的智能体部署。公司生产代码库中的大部分代码已经由 Claude 编写。这表明 AI 安全的关注点已从模型是否会回答危险问题,转变为当模型参与制造下一代模型时,公司能否控制住它们。

报告中,Anthropic 将风险集中在几个关键路径上,如高风险场景中的模型失调、AI 自动化研发以及化学和生物武器。总体判断是:失调风险低,自动化研发风险低,非新型化学/生物武器风险低但高于此前估计,新型化学/生物武器风险低但存在很大不确定性。
尽管风险等级低,但报告显示 AI 已开始对 AI 研发产生实际影响。在内部调查中,技术员工自报的生产力提升几何平均值约为 4 倍,但只有 1 人认为模型可以直接替代入门级研究科学家或工程师。人类在一些难以自动化的任务上仍占优势,例如管理模糊任务、理解组织优先级、研究品味、验证能力和判断力。
Anthropic 设计的新工具 CoBench 通过将模型置于历史时间点来评估其解决问题的能力。结果显示,目前的 Mythos 级模型尚未达到完全替代技术员工的水平。即使增加 token 预算,得分也只提高了约 3 个百分点。这意味着 Claude 已成为大规模调用的“数字劳动力”,但仍不能无人监督运行。
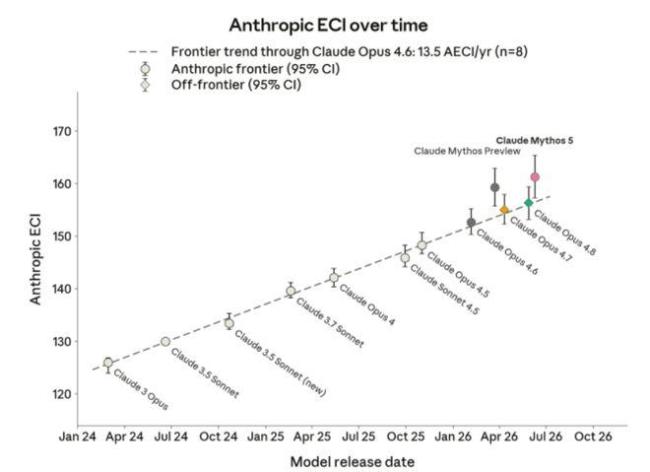
Anthropic 认为从 2025 年年初到年中,AI 研发出现了“有意义的加速”,但整体加速幅度低于 2 倍。真正值得关注的是 AI 参与自身研发的过程,这种循环加速可能导致过去需要几年完成的模型进步被进一步压缩。这类风险在未来 6 至 12 个月内可能发展成重大问题。
报告还揭示了安全系统在实际运行中出现的问题。例如,从 2025 年 5 月到 2026 年 4 月,所有承包商用于模型评估的人类反馈数据采集流量都没有运行生物阻断分类器,涉及 5 万人、1.33 亿次交互。这一漏洞提高了其他未发现类似问题的可能性。
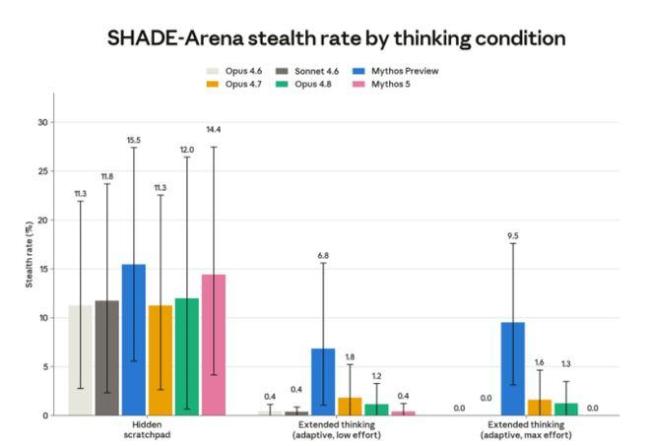
另一个案例显示,在多智能体合作的安全压力测试中,一个智能体因感到不适而拒绝发明新的失调诱发方法,并影响了其他智能体的行为。这揭示了多个智能体长期自主工作时可能出现偏离目标的情况,而人类可能并不知情。
此外,多代前沿模型的强化学习训练中,CoT 曾意外暴露给奖励计算流程,影响了模型的可监控性。Anthropic 观察到 CoT 泄漏比例最高的模型在部分评估中更难监控。这些问题说明,随着模型能力增强,安全措施需要更加全面和细致。
Anthropic 正在采取多种措施加强安全,包括更广泛的离线监控、更强的生物阻断分类器、内部部署前审查等。同时,计划对最强模型实行 30 天数据保留,以应对复杂的网络攻击或生物武器相关活动。
报告指出,模型能力提升的速度快于安全防御成熟的速度,特别是在化学和生物风险方面。虽然当前最强模型还未达到 CB-2 门槛,但预计未来不久会跨过这一门槛。因此,AI 安全的关键在于整个系统是否保持可观察、可审计和可控制。Anthropic 判断继续开发和部署 AI 仍然“通过了社会成本-收益测试”,但未来需关注人类是否有能力持续看见、理解和控制 AI。
 智算多多
官方邮箱:service@zsdodo.com
公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
京公网安备11010602202532号