



 智算多多
联系我们

官方邮箱:service@zsdodo.com

公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
关注我们

公众号

视频号
◎2025 北京智算多多科技有限公司版权所有 京ICP备 2025150592号-1  京公网安备11010602202532号
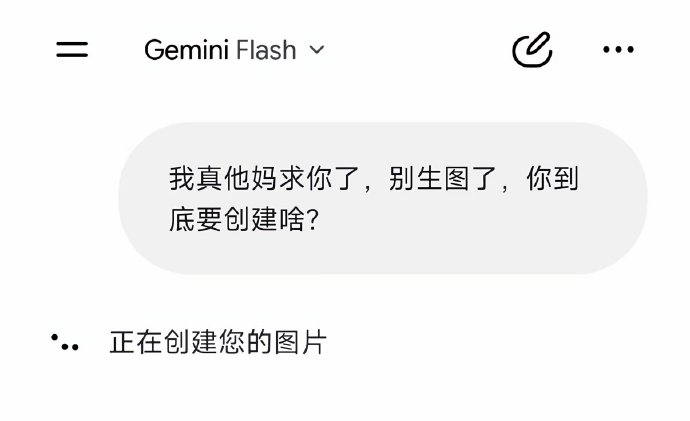
 工具调用阈值过低:谷歌将图像生成功能(基于Imagen模型)深度整合进Gemini的底层对话系统,导致系统对"图"字的敏感度极高。只要对话中出现"图"字,哪怕用户说的是"地图"、"索额图"这类与创作无关的词汇,Gemini也会无视上下文,立刻调用生图工具,甚至中断正在进行的代码编写任务。
意图识别不够精细:Gemini的意图判断机制过于依赖关键词匹配,缺乏对完整语境的校验。有用户实测,即便明确写出"不要生成图片",仍有约30%的概率触发自动生图。这种"听懂了两个字,剩下的都没听懂"的现象,根源在于多模态功能集成后,生图的优先级被意外抬高。
原生绘图模型高度集成:Gemini搭载了成熟的Imagen原生绘图模型,其图像生成能力在信息密度、空间逻辑、排版规整度等方面表现优异,能自动生成主图+局部细节图的组合,在信息类图像(如知识图谱、企业展厅方案)上甚至有碾压级优势。正是这种强大的能力,让系统倾向于"主动创作"。
生成式UI进一步复杂化路由:Gemini的最新版本加入了生成式UI功能,能够根据用户需求实时编码交互式界面。当系统在对话中检测到潜在的"可视化需求"时,会更积极地触发图像生成工具,导致日常闲聊场景也被强行植入绘画功能,产生"过度热情"的体验。
底层模型架构的激进变革:Gemini追求成为"首个原生多模态大模型",试图将文本、图像、UI等能力融为一体。这种整合虽然让图像生成效率极高,但也造成了意图识别层面的副作用——模型无法在"用户想聊"和"用户想画"之间做出精准区分,创作欲直接溢出屏幕。
工具调用路由仍需精细化:从用户反馈来看,Gemini对"图"字的过度反应不是简单的bug,而是产品设计中对工具调用路由的优先级设置问题。模型应该先确认用户是否真的需要图像,再决定是否拉起生图工具,而不是抢在用户指令之前"自作主张"。
"思考模式"提供有效缓解:有博主实测发现,开启Gemini的"深度思考"模式可以较好地抑制误触发。当模型进入更审慎的推理路径时,它会短暂判断用户是否有生图意图,从而避免盲目生成。
持续优化的积极信号:谷歌研发团队也在不断优化指令识别逻辑。Gemini应用的月活跃用户已突破7.5亿,巨大的用户基数带来了大量反馈,这有助于团队更快改进意图判定算法,让AI在"能画"的同时也懂得"该不该画"。
 智算多多
官方邮箱:service@zsdodo.com
公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
京公网安备11010602202532号