



 智算多多
联系我们

官方邮箱:service@zsdodo.com

公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
关注我们

公众号

视频号
◎2025 北京智算多多科技有限公司版权所有 京ICP备 2025150592号-1  京公网安备11010602202532号
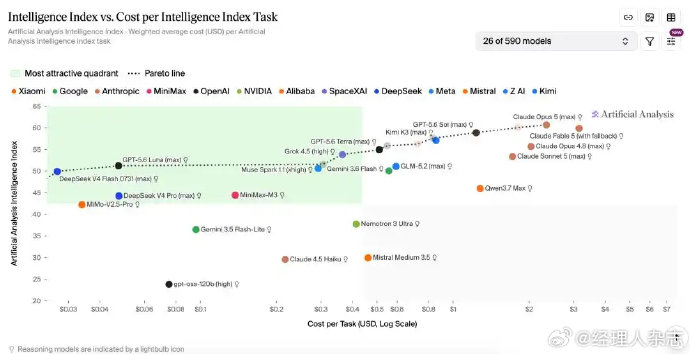
 官方定价:DeepSeek V4-Flash正式版输出2元/百万Token,缓存命中输入0.02元/百万Token。对比GPT-5.6 Sol(输出30美元/百万Token)成本差距达百倍以上。
市场碾压:美国研究机构Artificial Analysis实测显示,V4-Flash运行成本仅为Claude Fable 5的不到1/100,是全球知名模型中成本最低的一款。
降价倒逼:OpenAI被迫将GPT-5.6 Luna价格下调80%至1.2美元/百万Token,但单任务成本仍比DeepSeek高出约60%。
用量惊人:有开发者充入10元调用近2500万Token仅消耗2元,推理速度和质量均满意;另一开发者花1.5元就跑了2000万Token。
Agent成本骤降:过去受限于API账单的批量Agent业务得以放手尝试,10元额度可支撑大量自动化任务。
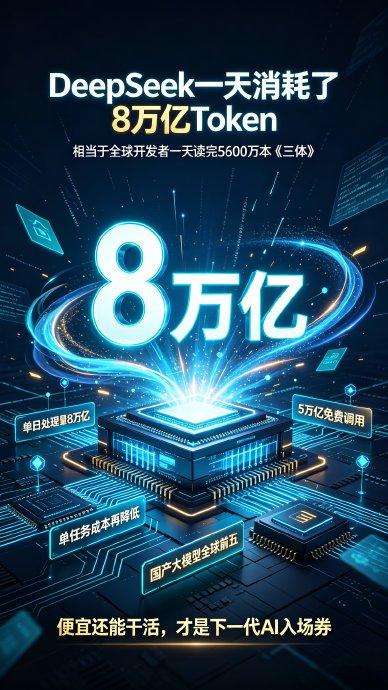
日流水估算:单日处理8万亿Token中3万亿为付费调用,按单价估算日流水约600万元,但相比同等规模海外模型成本已降低90%以上。
原生兼容:V4-Flash正式版原生支持OpenAI Responses API,无需中转工具即可直连Codex,配置即用告别繁琐适配。
零迁移成本:开发者无需修改现有工作流,在Codex界面中直接选择DeepSeek模型即可切换,同时保留Codex的终端编程体验。
开源加速普及:DeepSeek采用MIT开源协议,允许在消费级硬件本地运行,进一步降低算力门槛。
“斩杀线”效应:DeepSeek划定的“性能+成本”平衡线,迫使同一梯队中定价显著更高的模型持续流失中小开发者,OpenRouter周榜前五已连续14周被国产模型包揽。
普惠开发者:非编程人员也能以极低成本调用AI构建工具——有用户花43元通过Codex+DeepSeek搓出多平台发文助手,彻底打破“AI贵得用不起”的壁垒。
 智算多多
官方邮箱:service@zsdodo.com
公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
京公网安备11010602202532号