



 智算多多
联系我们

官方邮箱:service@zsdodo.com

公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
关注我们

公众号

视频号
◎2025 北京智算多多科技有限公司版权所有 京ICP备 2025150592号-1  京公网安备11010602202532号
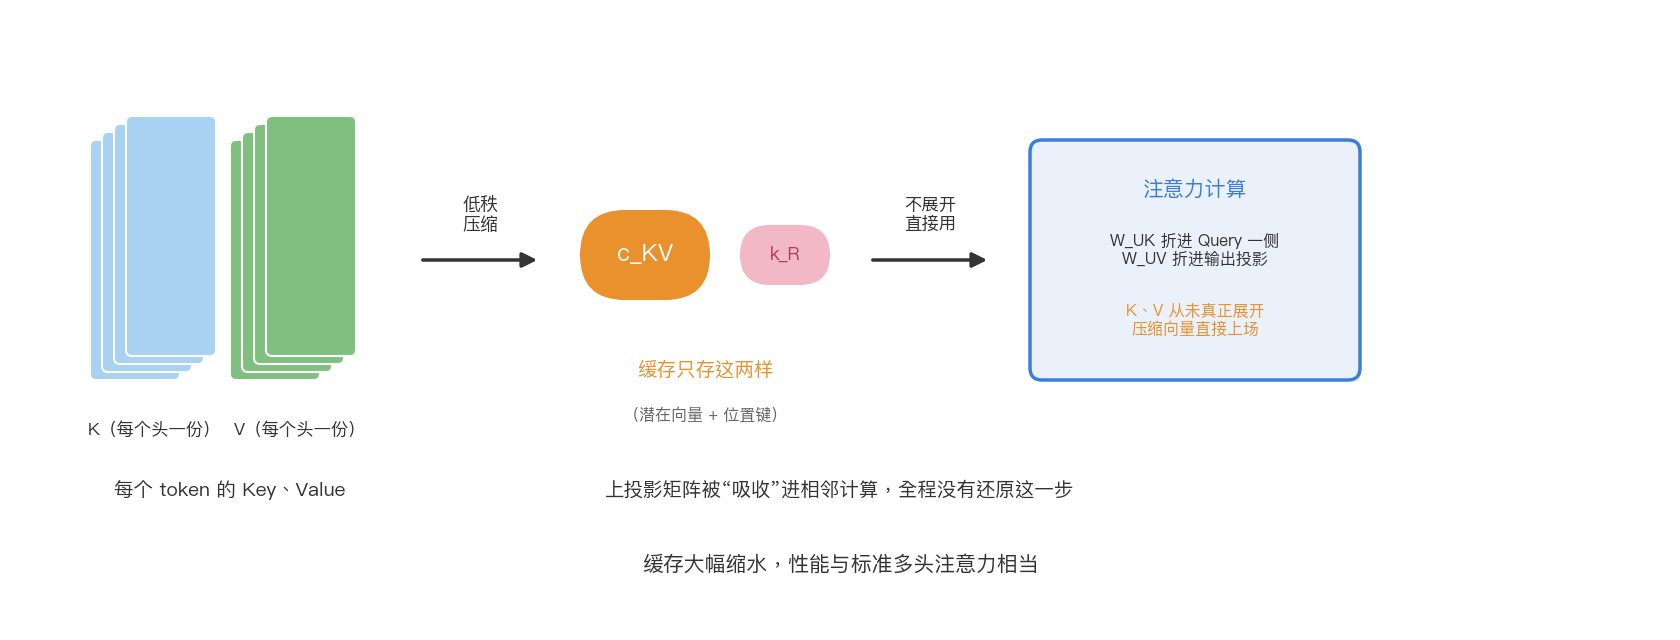
 大模型聊天时每生成一个 token,都要回头看前面所有 token 的 Key 和 Value——这些 K、V 得一直存在显存里,这就是 KV 缓存。对话越长,缓存越大:每个 token 的 K、V 都要按注意力头一份一份地存,长对话下来显存先装不下,推理也跟着变慢。
MLA(多头潜在注意力)的思路很像真空压缩袋:不直接存 K、V,而是把它们联合压缩成一个小得多的潜在向量 c_KV——每个 token 只存这一小条,外加一个携带位置信息的解耦键 k_R。但跟压缩袋不同的是,取用的时候根本不需要"拆袋":上投影矩阵被"吸收"进了相邻的计算里——算注意力分数时,它折进 Query 一侧,query 直接拿压缩向量算分;算输出时,它折进输出投影,先对压缩向量加权求和、最后一次投影出去。各头的 K、V 从头到尾没有被真正展开过,压缩向量直接上场干活。
为什么位置信息要单独留一条?因为 RoPE 这类位置编码跟上投影矩阵没法交换顺序——一旦揉进压缩,刚才说的"折叠吸收"就失效了。所以干脆留一条小的专用通道,位置键直接从输入算出来,不跟内容挤。
效果上,KV 缓存大幅缩水,性能却与标准多头注意力基本相当。查询(Query)端也做了同样的低秩压缩,省的是训练时的显存。
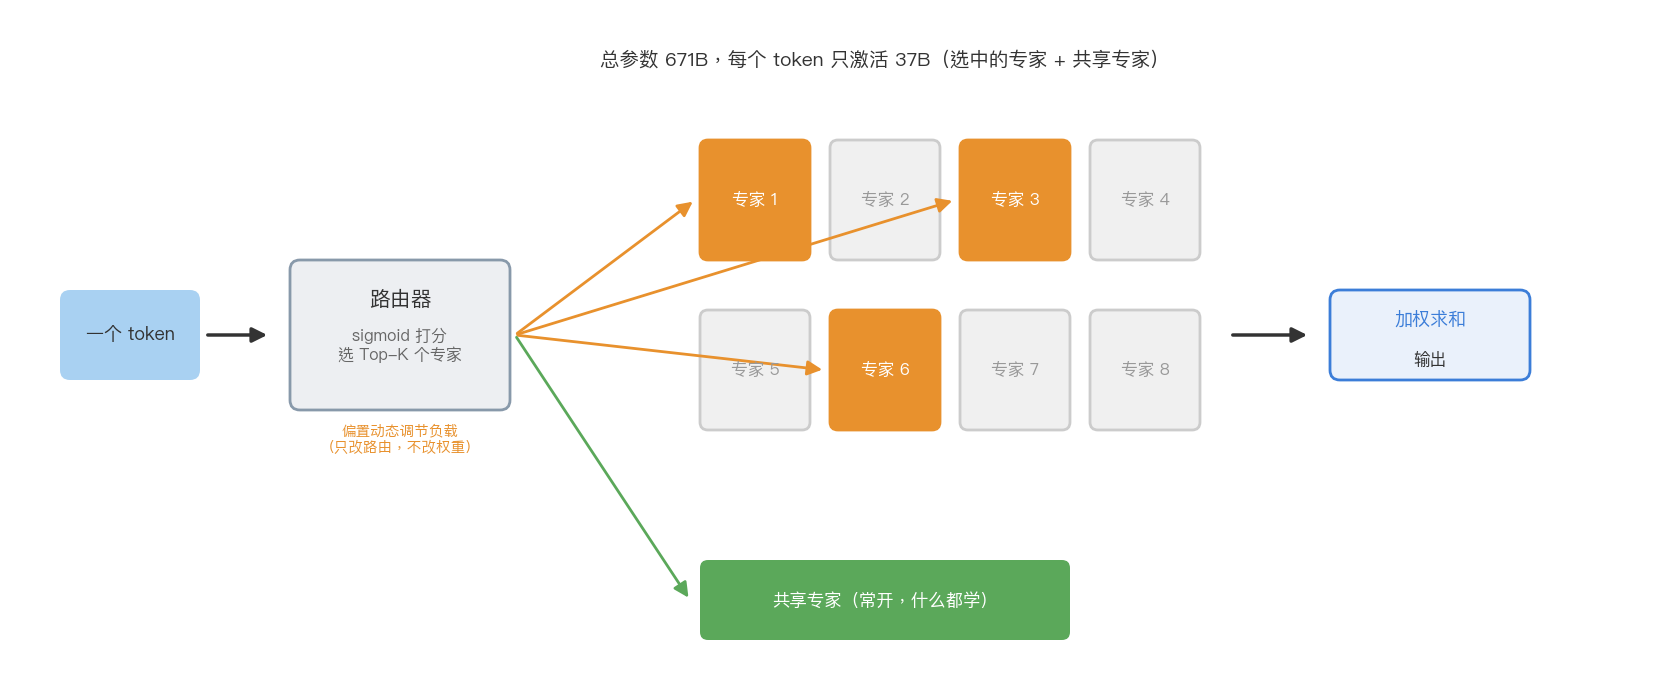
模型越大通常越强,但 6710 亿参数全部激活一次,代价太高。MoE(混合专家)的解法是开一家"专科医院":把前馈层换成一大群专家,每个 token 进门先由"分诊台"(路由器)按 sigmoid 亲和度打分,只派给得分最高的 Top-K 个专家处理,其余专家歇着。这里的专家不是一个个独立模型,而是规格相同、参数各异的前馈网络——同一个模子,各自学出了不同的专长。账面上 6710 亿参数,每个 token 实际只激活 370 亿。
DeepSeekMoE 在这个框架上做了两处改良:专家切得更细(细粒度专家,分工更专),另设几个共享专家——相当于全科门诊,什么病都看,保证基础知识不丢。
真正难的是负载均衡:如果分诊台总把病人往少数几个专家那儿送,其他专家闲置,就会"路由塌缩"。传统的解决办法是加一个辅助损失,逼着分诊台均衡分配,但辅助损失太大又伤模型性能。V3 的方案是无辅助损失的负载均衡:给每个专家设一个偏置项,分诊时加在分数上——过载的专家下一步就减一点,欠载的就加一点。关键在于偏置只影响"选不选它",不影响选中之后"它的意见占多大权重"。相当于交通协管员只负责调度车流,从不进手术室。
配套还有三样补丁。一是留一道"保险丝":保留一个权重极小的序列级均衡损失,只管单条序列内部别一边倒,系数小到不碍性能。二是给路由设限:每个 token 最多发往 4 个节点(服务器),按各节点上专家的亲和度总和挑,牺牲一点选择自由,换来跨机通信可控。三是不"拒收":专家不设容量上限,训练和推理全程一个 token 都不丢。
标准语言模型每次只预测下一个 token,V3 加了 MTP(多 token 预测):用一串串联的模块依次预测未来好几个 token,每一级都把前一级的表示和真实的下一个词的嵌入拼起来接着猜,保持完整的因果链。这样训练信号更密,模型还能提前为将来"打腹稿"。推理时这些模块可以直接丢掉,也可以留下来做投机解码加速生成。
训练账单同样克制:14.8 万亿 token 的预训练,用 2048 块 H800 跑了 278.8 万 GPU 小时,按市场价约 557.6 万美元——这里面还包括了 FP8 混合精度训练的首次大规模验证,全程没有一次损失尖峰,没有一次回滚重训。
成绩同样扎实:MMLU 88.5、MMLU-Pro 75.9、GPQA 59.1、MATH-500 90.2、AIME 39.2、Codeforces 51.6、SWE-bench 42.0——当时的最强开源基座,综合表现比肩 GPT-4o 和 Claude-3.5-Sonnet。
557 万美元能训完 671B 的模型,靠的不只是架构省钱,还有一整套工程配合。
训练端,流水线是双向的。传统流水线并行里 GPU 总要等上下游的空档(气泡),V3 的 DualPipe 从流水线两端同时喂入数据,正向和反向的计算块两两配对,让计算与跨节点通信互相重叠——通信藏在计算背后,气泡砍掉一半。跨节点通信也做了定制:每个 token 最多发 4 个节点,先走 IB 到目标节点的"同编号"GPU,再立刻转 NVLink 送达,两段传输完全重叠,只用 20 个 SM 就打满了两种带宽。
部署端,专家可以开"分身"。预填和解码分开部署(最小 32 卡与 320 卡),线上每 10 分钟统计一次专家负载,热门专家复制副本重新排布——预填阶段常备 32 个冗余专家。MTP 模块留在推理时做投机解码,第二个 token 的接受率 85% 到 90%,整体吞吐再提 1.8 倍。
最特别的是,DeepSeek 还给硬件厂商反向开了一份需求清单:132 个 SM 里有 20 个被拉去干通信的活,建议下代芯片把通信卸载给协处理器;H800 的 FP8 累加精度只有 14 位,而他们至少需要 34 位,建议提高累加精度、原生支持细粒度量化——这些需求公开放在那里,留给下一代硬件去兑现。
V3 的推理能力来自 DeepSeek-R1 的蒸馏,但直接拿 R1 的输出当教材有个问题:准是准,就是话太长、格式还差。于是蒸馏之前先"驯化"数据:每个领域单独训一个专家模型,训练时把"问题 + 原始回答"和"系统提示 + 问题 + R1 回答"两类数据混着喂,再用高温采样让模型自己融合两种风格,最后拒绝采样挑出既准确又简洁的回答当教材。整套教材 150 万条;消融显示,照单全收 R1 的风格确实更准,但回复长度会失控——V3 的教材是精心选过的平衡点。
强化学习的奖励信号则分两条腿:能写死规则的一律用规则——数学题按格式判对错、代码题交给编译器跑测试,规则不会被"刷分";开放式问题才让模型当裁判,而且用 GRPO 算法砍掉了与策略模型同样大的 critic,组内评分自己当基线。更开放的问题干脆让 V3 自己投票给自己打分(自我奖励),它在 RewardBench 上的判断力(投票后 89.6)已经超过了当时的 GPT-4o。
上下文拉到 100 万 token 时,注意力的计算量随长度平方增长,KV 缓存线性增长,V3 的省法不够用了。V4 的答案是两种新注意力层混合排布。
CSA(压缩稀疏注意力) 分两步走。第一步压缩:每 m 个相邻 token 的 KV,用一组带位置偏置的 softmax 权重压成 1 条,序列长度先缩到 1/m。第二步稀疏:一个轻量的"闪电索引器"给每条压缩 KV 与当前 query 的相关性打分,只取分数最高的 top-k 条进入注意力。另外再保留一小段最近距离的原始 KV(滑动窗口),近处的细节不经过压缩,直接看原件。最后,注意力用共享 KV 的 MQA 形式,输出端分组投影省算力。
HCA(重度压缩注意力) 更激进:每 m′ 个 token(m 的很多倍)压成 1 条——序列已经短到不需要再挑了,直接做密集注意力。

两种层混排之后,100 万 token 上下文里,V4-Pro 的单 token 推理 FLOPs 只有 V3.2 的 27%,KV 缓存只有 10%;小号的 V4-Flash 更省:FLOPs 10%、KV 缓存 7%。百万 token 从"演示视频里的能力"变成了可以日常使用的配置。
残差连接是 Transformer 的生命线:原始信号一路直通,每层只补充修正量。超连接(HC)的想法是把这条直通车道拓宽几倍,让层与层之间的交流更充分——但车道一宽,信号容易在堆叠中失控,训练频繁出现数值不稳。
mHC(流形约束超连接)给拓宽的车道装上护栏:把残差映射矩阵约束到"双随机矩阵"的流形上——矩阵的每行每列之和都是 1、元素非负,谱范数不超过 1,意味着信号经过映射既不放大也不消失。实现上用 Sinkhorn 迭代 20 步把矩阵投影过去;输入、输出两端的映射则用 sigmoid 压到非负有界,防止信号相互抵消。拓宽照做,稳定也保住了。落地的代价也控制得住:配合融合 kernel、选择性重计算和流水线调度调整,mHC 的额外开销压到了 6.7%。
优化器也换了:V4 全线改用 Muon,收敛更快,长训练更稳。
V4-Pro 的最强模式(Pro-Max)在 SimpleQA 和中文 SimpleQA 上做到开源第一;推理成绩超过 GPT-5.2 和 Gemini-3.0-Pro,与 GPT-5.4、Gemini-3.1-Pro 的差距缩到大约三到六个月;Agent 任务上超过 Claude Sonnet 4.5,接近 Opus 4.5;长文本学术评测里甚至压过 Gemini-3.1-Pro。V4-Flash-Max 走性价比路线,加大思考预算也能摸到 GPT-5.2、Gemini-3.0-Pro 的水平。
更贴近日常使用的评测也给出了答案:中文功能性写作对 Gemini-3.1-Pro 胜率 62.65%;agentic 搜索对 RAG 胜率 61.7%;30 个中文高阶职业任务上对 Opus-4.6-Max 的非败率 63%;内部工程师出的代码题通过率 67%,明显超过 Claude Sonnet 4.5 的 47%。
官方也坦率标出了边界:在 100 万 token 里"捞针"的 MRCR 测试(8 根针)中,128K 以内得分稳定在 0.9 以上,但拉满 100 万 token 时会掉到 0.59——百万上下文可用,但还不是没有代价的。
回看两代的成绩曲线:V3 证明开源可以便宜地"比肩闭源",V4 证明开源可以便宜地"摸到前沿"。
V3 解决的是"能不能便宜地强",V4 解决的是"能不能便宜地长"。从 MLA 的 KV 压缩到 MoE 的分诊,从 CSA/HCA 的压缩稀疏到 mHC 的护栏,DeepSeek 每一代做的都是同一件事:把每一分算力的水分拧干,再把拧出来的空间换成能力。
 智算多多
官方邮箱:service@zsdodo.com
公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
京公网安备11010602202532号