

 智算多多
联系我们

官方邮箱:service@zsdodo.com

公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
关注我们
公众号
视频号
◎2025 北京智算多多科技有限公司版权所有 京ICP备 2025150592号-1  京公网安备11010602202532号
 谷歌正式向全球用户免费开放Gemini 3 Flash——这款模型在多项基准测试中达到甚至超越旗舰级Gemini 3 Pro的表现,但运行速度是前代Gemini 2.5 Pro的3倍,每百万输入Token仅需0.50美元。这不是又一次常规的模型迭代,而是谷歌在AI商业化的关键节点上,投出的一枚“效率炸弹”。
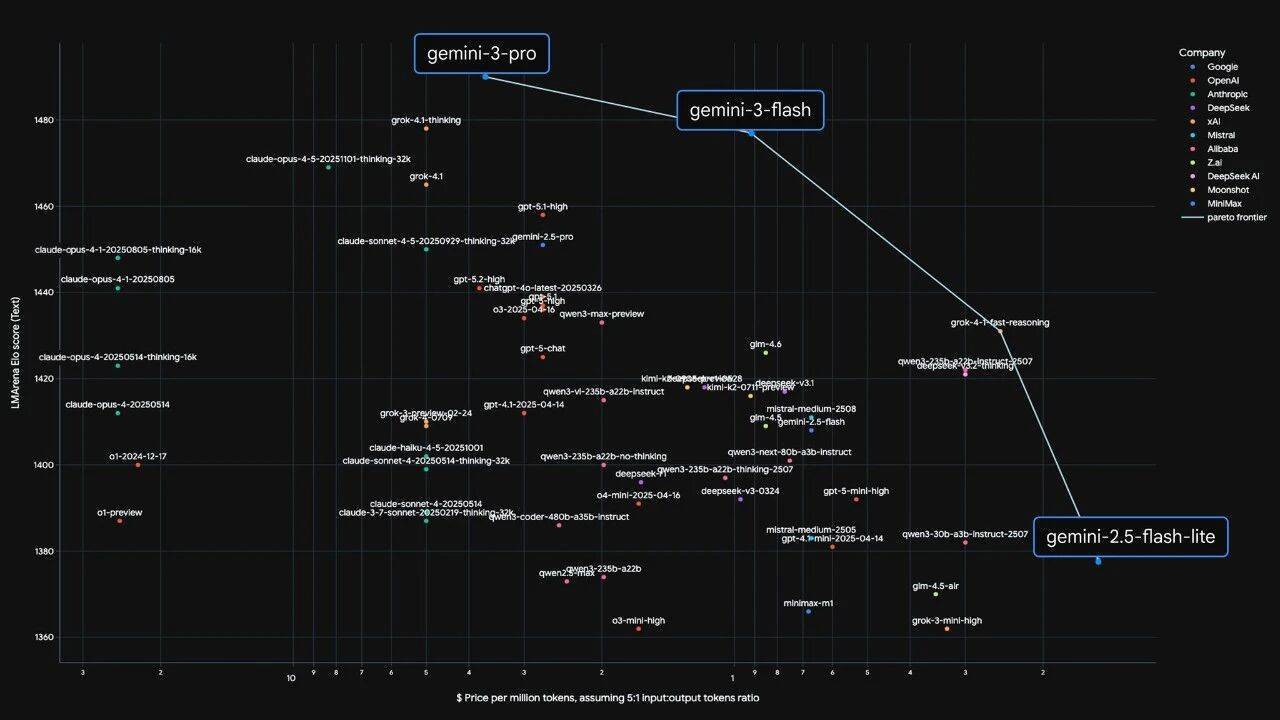
长期以来,AI行业存在一个隐含假设:模型越大越聪明,但推理越慢越贵。Gemini 3 Flash的核心突破在于打破了这个悖论。
在GPQA Diamond(博士级专业知识推理测试)中,它取得了90.4%的成绩;在SWE-bench Verified(编码代理能力基准)中达到78%,超过Gemini 3 Pro;在多模态测试MMMU Pro中获得81.2%,与旗舰版不相上下。
Gemini 3 Flash引入动态思维调节——处理日常任务时快速给出精准答案,遇到复杂问题时自动加深推理层级。在典型流量测试中,达到同等性能所需的Token数量比Gemini 2.5 Pro平均减少30%。这意味着同样的任务,企业API成本直接降低近三分之一。
Gemini 3 Flash已正式成为Gemini App的默认模型,同时作为Google搜索AI Mode的底层引擎向全球推送。全球用户无需付费即可使用。
这一策略的逻辑非常清晰:在AI模型从“技术展示”走向“大规模商业化”的关键阶段,谷歌选择用免费策略抢占用户入口和开发者生态。每百万输入Token 0.50美元、输出Token 3.00美元的定价,已远低于竞品水平。
开发者可通过Google AI Studio、Vertex AI和全新的代理开发平台Google Antigravity调用该模型。在代理式AI(Agentic AI)场景中,低延迟和快速反馈循环的优势,往往比单纯的大参数量更具商业价值。
Gemini 3 Flash的发布,折射出AI产业一个深层趋势:模型竞争正在从“谁更大”转向“谁更高效”。
当Token成本成为企业部署AI的核心考量时,效率模型的商业价值可能超过旗舰模型。一个速度更快、成本更低、且在多数任务上表现足够好的模型,对企业用户的吸引力远超需要十倍成本才能运行的“最强模型”。
这对整个行业的定价逻辑形成冲击。此前,AI模型厂商的商业模式建立在“模型越大→效果越好→企业愿意付更多钱”的线性逻辑上。Gemini 3 Flash证明,通过架构创新和动态调度,完全可以在更低的成本基础上实现同等甚至更好的效果。
谷歌搜索正在将Gemini 3 Flash作为AI Mode的默认引擎。当全球数十亿次搜索请求都通过这款效率模型处理时,其成本优势将被放大到极致。
未来的AI模型竞争,不再只是比参数、比跑分,更是比谁能用更少的资源做更多的事。
 智算多多
官方邮箱:service@zsdodo.com
公司地址:北京市丰台区南四环西路188号总部基地三区国联股份数字经济总部
京公网安备11010602202532号